Introducción
Por qué los negociadores recurren a estas herramientas, en qué son buenas y cómo leer este libro.
Las negociaciones sobre el clima se basan en documentos. Hay miles, escritos con un vocabulario especial que cambia de una sesión a otra. Las palabras exactas de un texto pueden decidir el resultado. Los modelos de lenguaje de IA pueden ayudarte a leer, escribir y prepararte más rápido.
1.1¿Por qué debería importarnos?
Los jóvenes negociadores en las conversaciones de la ONU sobre el clima (la UNFCCC) hablan por la generación que vivirá con las decisiones de hoy. Muchos afrontan los mismos problemas. Hay demasiado que leer. El lenguaje de las políticas es difícil de seguir. Y hay poco tiempo para transmitir una idea.
Los modelos de lenguaje pueden ayudar con todo esto. Un modelo de lenguaje es un programa informático entrenado con una enorme cantidad de textos. Puede leer, resumir y escribir textos cuando se lo pides. Para los negociadores, resulta útil de cuatro maneras.
Entender la información. Convertir informes largos y datos en resúmenes breves para estar al día de los nuevos hallazgos.
Redactar. Ayudarte a expresar una idea en el lenguaje aceptado en las negociaciones, con la claridad necesaria para que se tenga en cuenta.
Trabajar entre idiomas. Traducir textos y explicar su contexto para que más personas puedan participar en igualdad de condiciones.
Practicar. Representar a la otra parte en una negociación simulada para que puedas ensayar antes de la real.
La herramienta es solo una parte. Los negociadores que aprenden a usarla bien tienen más tiempo para el trabajo que necesita a una persona.
1.2Cómo usar esta guía
La primera mitad explica qué son estos sistemas, qué necesitan los negociadores y cómo pedirle algo útil a un modelo. La segunda mitad trata sobre los agentes. Un agente es un modelo que puede leer un conjunto de documentos y realizar una tarea en varios pasos. Los últimos capítulos explican quién controla tus datos, cómo ejecutar un modelo por tu cuenta y qué coste tiene la IA para el medio ambiente. Cada capítulo incluye instrucciones que puedes copiar. No necesitas conocimientos técnicos.11La primera edición se escribió en 2024 para el Climate Youth Negotiator Programme. Las entrevistas del capítulo 3 y del apéndice proceden de ese trabajo.
¿Qué son los grandes modelos de lenguaje?
Del perceptrón al asistente en su navegador. Qué son estos sistemas y de dónde vienen.
2.1Cómo llegamos hasta aquí
En 1957, el psicólogo Frank Rosenblatt empezó a trabajar en el perceptrón en el Cornell Aeronautical Laboratory. La Marina de Estados Unidos mostró una máquina de perceptrón en funcionamiento al año siguiente. Un perceptrón es un modelo matemático muy simple de una célula cerebral. Recibe varias entradas, asigna un peso a cada una y produce una salida. No copiaba un cerebro real, pero los sistemas de IA actuales surgieron en parte de él.
Luego, el progreso se estancó durante décadas. No había suficientes datos, los ordenadores eran demasiado lentos y los métodos de entrenamiento eran poco eficaces. El avance se reanudó cuando los tres mejoraron a la vez. En 2012, Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton entrenaron un sistema llamado AlexNet con 1,2 millones de imágenes etiquetadas, usando chips gráficos diseñados para videojuegos. La respuesta correcta estaba entre sus cinco primeras opciones salvo en el 17 por ciento de las imágenes de prueba, un resultado muy superior a los anteriores.11El resultado se debió tanto al diseño, las técnicas de entrenamiento y el conjunto de datos como al hardware.
En 2017, investigadores de Google presentaron el Transformer. Un Transformer mira todas las palabras de un pasaje a la vez y calcula cuáles son relevantes entre sí. Esto le permite conectar ideas que están muy separadas en un texto. Los Transformers también se entrenan rápido con muchos chips a la vez. Casi todos los sistemas de esta guía se basan en uno.
OpenAI entrenó después Transformers en una tarea simple: predecir la siguiente palabra. Sus primeros modelos, GPT y GPT-2, mostraron que esta sola tarea enseñaba muchas habilidades a un modelo a la vez. Ya no hacía falta un sistema distinto para cada trabajo. Los investigadores también descubrieron las leyes de escalado. Los modelos mejoraban de forma predecible al recibir más capacidad de cómputo, más datos y más tamaño, siempre que los tres crecieran juntos.
El 30 de noviembre de 2022, OpenAI lanzó ChatGPT como una versión preliminar gratuita para investigación. Por primera vez, cualquiera podía conversar con uno de estos modelos.
Luego llegaron dos cambios más. En septiembre de 2024, OpenAI anunció o1 y, en enero de 2025, DeepSeek lanzó R1. Ambos dedican más esfuerzo antes de responder. Primero escriben notas de trabajo más largas, lo que ayuda con problemas que requieren varios pasos. También se conectaron los modelos a herramientas y se les permitió actuar en bucles. El capítulo 6 trata este tema.
2.2La receta
Un modelo de lenguaje es un tipo de IA que lee y escribe lenguaje humano. Aprende de una enorme cantidad de texto: libros, artículos, sitios web y más. De ese texto aprende patrones y los usa para escribir texto nuevo.
ChatGPT, Llama de Meta y otros modelos similares se construyen en dos etapas. Primero viene el preentrenamiento. Luego viene el posentrenamiento, que ahora tiene dos partes. La segunda parte permite que los modelos recientes resuelvan problemas largos.
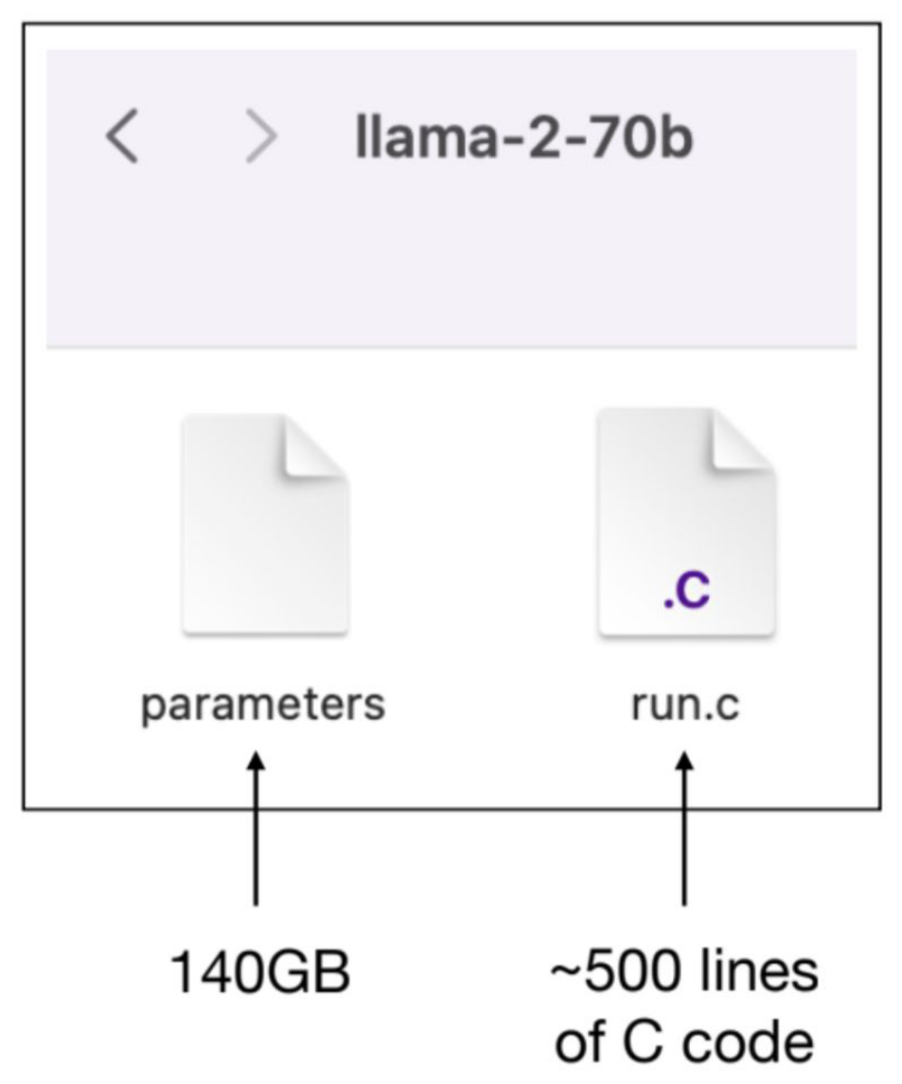
Preentrenamiento. El modelo lee una enorme cantidad de texto de internet y practica la predicción de la siguiente palabra. No guarda una lista de lo que leyó. En el proceso aprende gramática, datos sobre el mundo y cierta capacidad de razonar. Aprende una cantidad sorprendente de cosas así, desde pequeños datos cotidianos hasta ideas difíciles.
Ajuste fino supervisado. La primera parte del posentrenamiento. Las personas escriben y evalúan respuestas de ejemplo, siguiendo pautas escritas. El modelo se entrena con estos ejemplos y aprende a aplicar el mismo criterio a nuevas peticiones. Este paso le enseña a seguir una instrucción en vez de solo continuar tu frase.
Aprendizaje por refuerzo. La segunda parte, más reciente. Al modelo no se le muestra una respuesta correcta que copiar. Recibe una recompensa cuando logra un buen resultado. Con el tiempo aprende qué formas de resolver un problema funcionan. Esto le permite mantener una larga cadena de pasos antes de responder.
2.3Limitaciones
Los investigadores aún no entienden del todo cómo funcionan estos modelos por dentro. La idea más extendida es que el preentrenamiento le da al modelo sus conocimientos y el posentrenamiento moldea cómo los usa.
Una cosa está clara. Un modelo de lenguaje elige la siguiente palabra según los patrones del texto con el que se entrenó. Eso funciona bien para muchas tareas, pero tiene dos grandes problemas. El modelo repite los sesgos del texto del que aprendió. Y afirma cosas falsas con total seguridad. Esto se llama alucinación. Una frase que suena bien no se ha verificado.
2.4De dónde viene el sesgo
Estos modelos aprenden de internet e internet no cubre el mundo por igual. Para quien negocia sobre el clima, esto importa mucho.
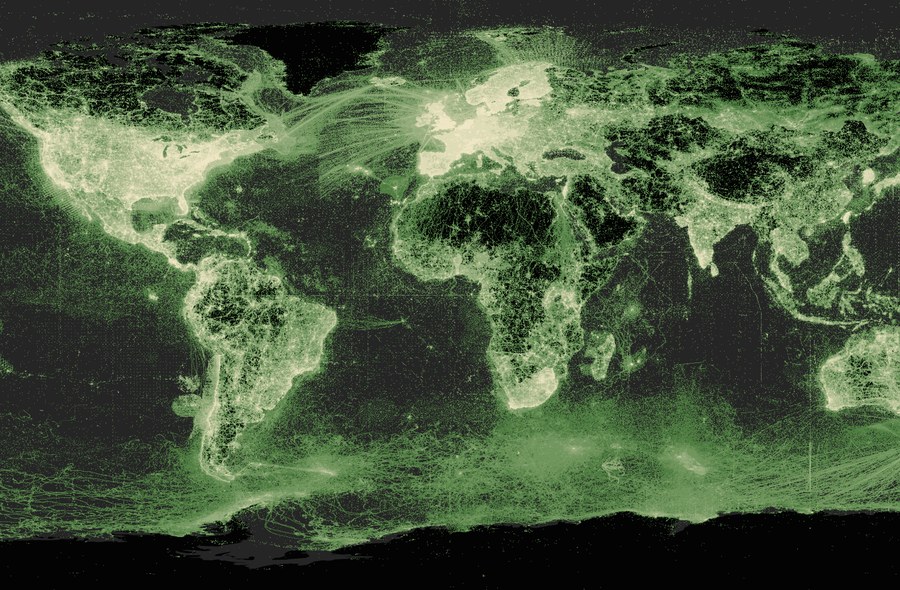
Tomemos los registros de la naturaleza. La Infraestructura Mundial de Información en Biodiversidad (GBIF) es la mayor base de datos abierta de avistamientos de especies del mundo. Cerca del 83 por ciento de sus registros procede de América del Norte y Europa. El otro 17 por ciento cubre el resto del mundo, incluidos los lugares con más especies.
Los textos escritos tienen el mismo desequilibrio. Hay mucho más contenido en internet en inglés, francés y español que en quechua, twi o tok pisin. Por eso, un modelo ha visto mucho más del primer grupo. Traducirá, resumirá y redactará bien en una lengua común. En una menos común cometerá más errores, y lo hará con la misma seguridad.
Esta es también una causa importante de las alucinaciones. Si preguntas por un lugar bien documentado, el modelo recurre a mucho material. Si preguntas por uno poco documentado, tiene mucha menos información en la que basarse, así que rellena los huecos con suposiciones. La respuesta no suena menos segura. Simplemente es más probable que sea incorrecta.
No es fácil culpar a alguien de esto. Recopilar y publicar datos cuesta dinero y requiere sistemas de los que muchos países carecen. Algunas comunidades deciden no compartir conocimientos sobre sus tierras y especies, y están en su derecho. Pero el resultado es el mismo. Estas herramientas funcionan mejor para los lugares que ya tienen muchos datos y peor para los que más se juegan.
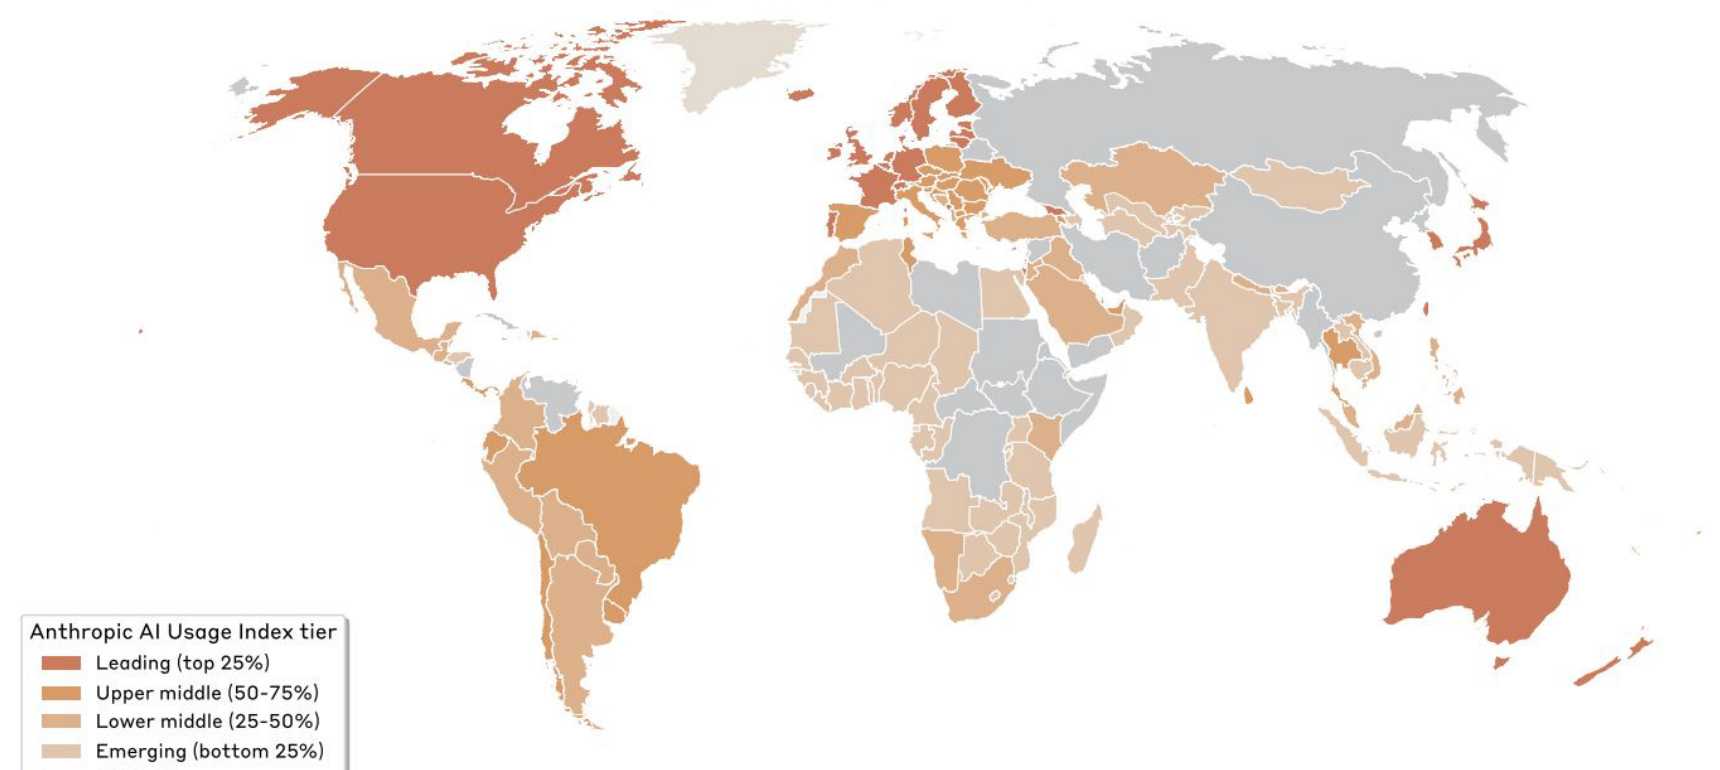
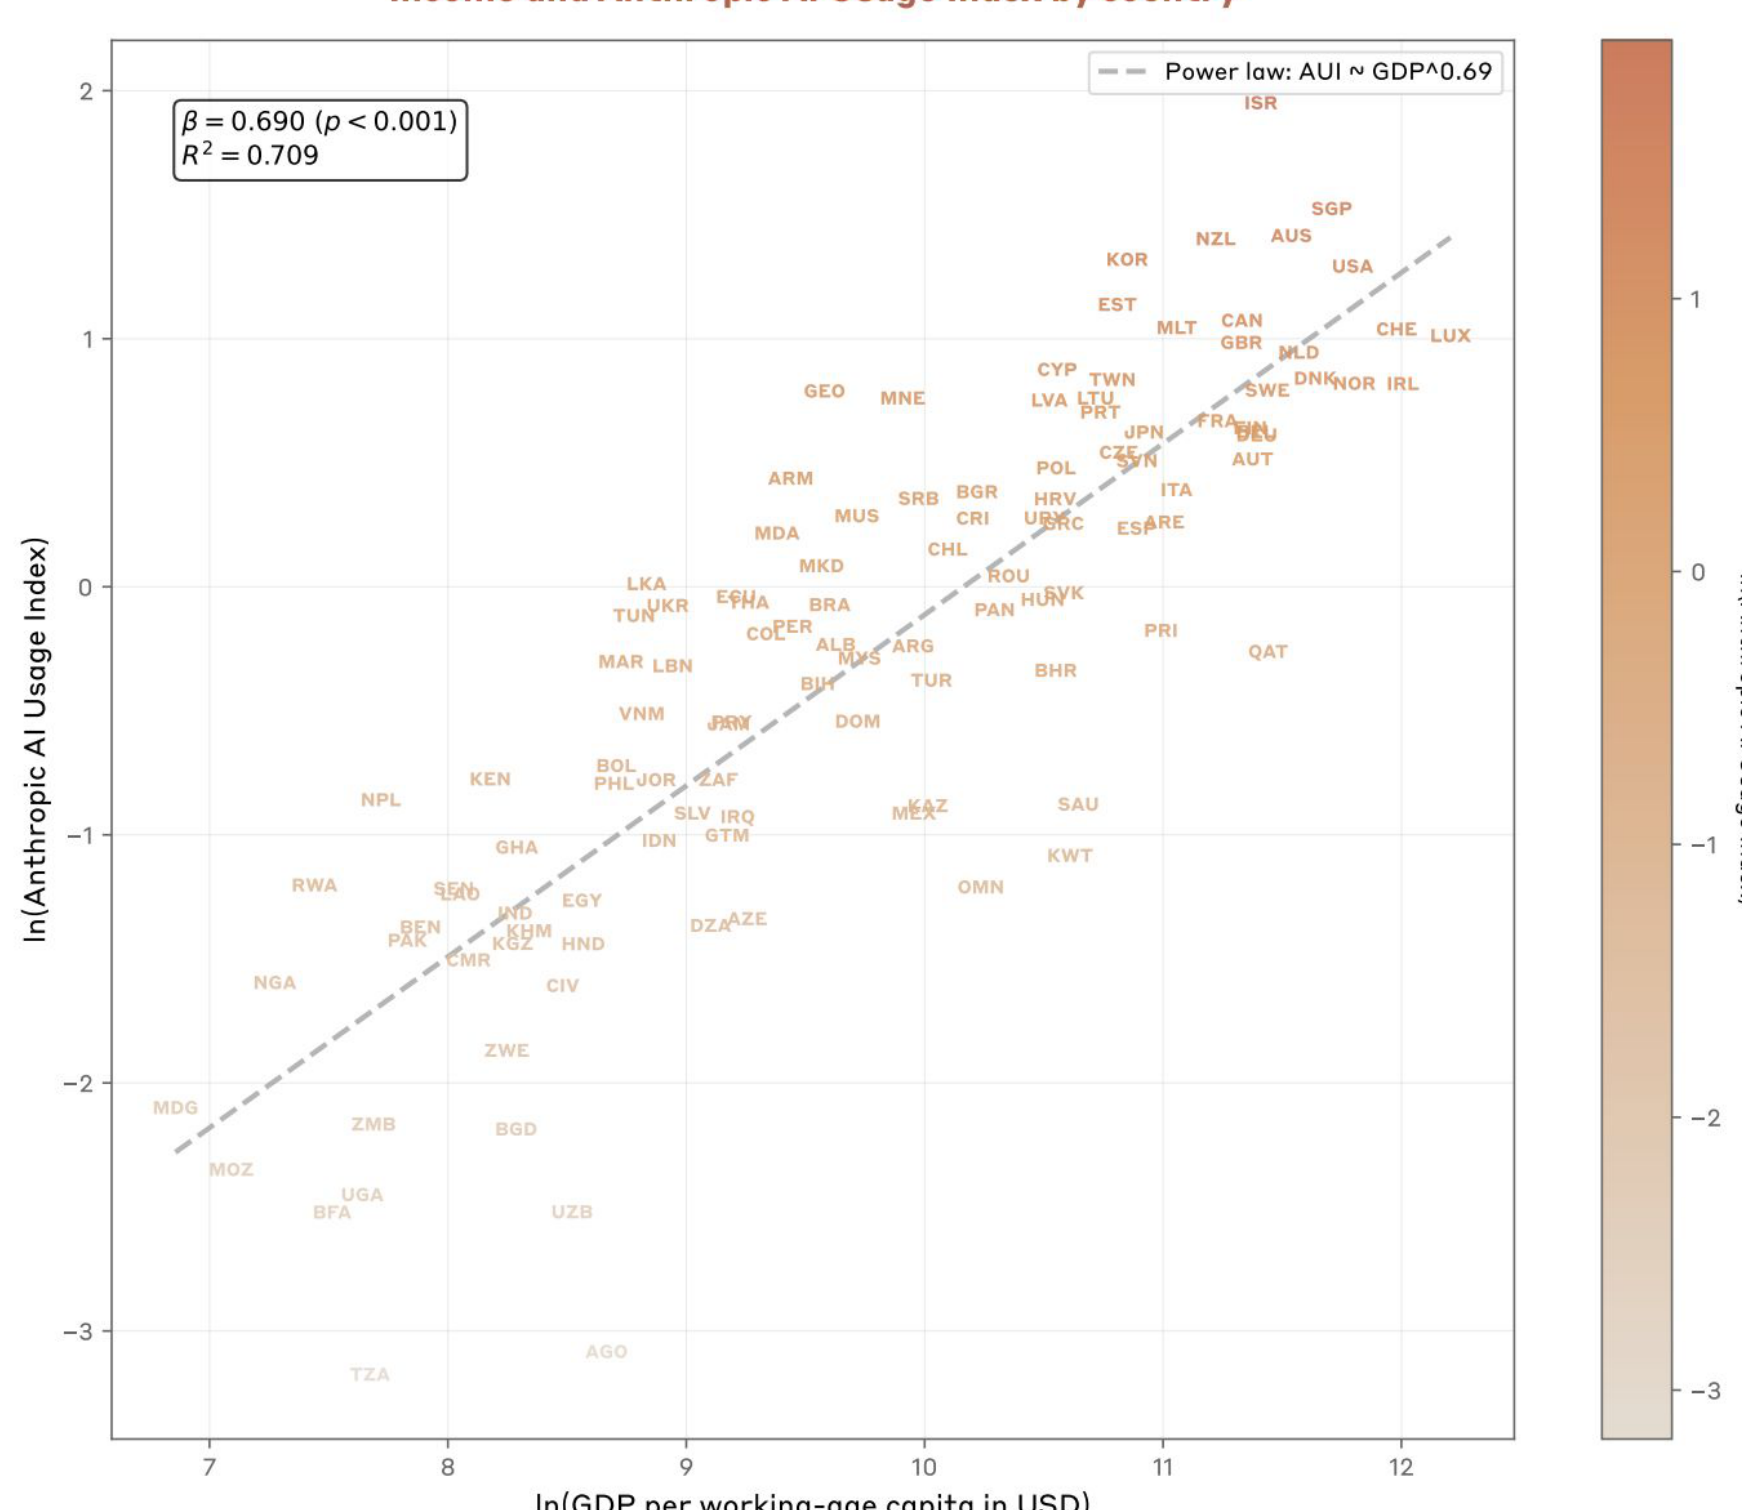
La misma brecha aparece entre quienes usan estas herramientas. Anthropic publica un índice del uso de Claude por país. El uso aumenta de la mano de los ingresos nacionales, y veinticinco países apenas lo usan.22Anthropic, Anthropic Economic Index, 2025. El uso crece con el PIB por persona en edad de trabajar elevado a una potencia de aproximadamente 0,69. Entre ellos están Tonga, Samoa, Nauru y Palau. Estos países son partes en las mismas negociaciones y están entre los más expuestos al cambio climático.
Perspectivas de las partes interesadas
Jóvenes negociadores nombran lo que hace difícil el trabajo. Sus respuestas fijan el listón para cada herramienta de este libro.
Entrevistamos a jóvenes negociadores climáticos de varios países. Describieron los mismos problemas y buscaban ayudas similares.11Seis negociadores de Liberia, Paraguay, Perú, Nigeria, Líbano e Indonesia. El resumen completo está en el apéndice.
3.1Principales retos y dificultades
Idioma. La mayoría de las personas en la sala no tienen el inglés como lengua materna.
Términos técnicos. Aprender la jerga de la UNFCCC lleva años (Liberia, Paraguay).
Transmitir conocimientos. Algunas personas tienen los conocimientos técnicos y otras no. Gran parte se pierde cuando cambian los delegados entre sesiones.
Historia. Es difícil saber qué ocurrió en negociaciones anteriores (Líbano).
Hablar con negociadores experimentados. Estas conversaciones son difíciles bajo presión (Perú, Nigeria). Los delegados más jóvenes tienen que ganarse el respeto antes de que los demás los escuchen.
Entender a otras Partes. Las posiciones cambian rápido y son difíciles de seguir.
Tiempo. Nunca hay tiempo suficiente para asimilar todo lo que importa.
Hablar con claridad. Expresar una idea compleja de forma rápida y precisa en inglés es una lucha constante.
3.2Herramientas y recursos deseados
Herramientas de idioma. Mejor ayuda con la redacción y la gramática, pensada para textos de la UNFCCC en lugar del inglés de negocios.
Búsqueda rápida. Herramientas que revisen documentos largos, extraigan las partes importantes y confirmen qué versión de un texto es la más reciente.
Formación adaptada. Materiales de aprendizaje adecuados a la región, el grupo de negociación y la experiencia de cada negociador.
En el momento de las entrevistas, los negociadores usaban Grammarly para escribir y Google Drive para trabajar juntos. Un negociador no usaba ninguna herramienta de traducción, porque el lenguaje de negociación pierde su sentido al traducirse.
LLM para las negociaciones
Dónde ayuda un modelo de lenguaje en el ciclo de negociación, y dónde no.
Las negociaciones climáticas abarcan muchos temas a la vez: emisiones, biodiversidad, dinero y política. Para mantenerse al día, quien negocia necesita tres cosas.
Acceso rápido a la información. La ciencia del clima sigue cambiando, y quienes negocian necesitan los datos más recientes cuanto antes.
Redacción cuidadosa. Una palabra en un acuerdo puede hacer que funcione o que fracase.
Muchos idiomas. Las Partes vienen de todas partes y hablan muchos idiomas.
4.1Dónde ayudan los modelos
Comunicación. Redactar y traducir textos para que las Partes con distintas lenguas maternas se entiendan bien.
Investigación. Recopilar y resumir grandes cantidades de material, como estudios científicos, documentos sobre políticas y acuerdos anteriores, para mantenerte al día.
Explorar escenarios. Analizar los posibles resultados de distintas políticas para poner a prueba una postura antes de adoptarla.11A veces esto se llama modelización predictiva, pero el término exagera lo que hace. Los modelos de lenguaje no ejecutan modelos climáticos ni económicos. Reformulan y comparan escenarios, y toda cifra que produzcan debe contrastarse con una fuente real.
Resumir argumentos. Exponer lo que ha defendido cada Parte para ver los puntos principales y los argumentos en contra.
4.2Posibles problemas
Los beneficios son reales. Los riesgos también, y algunos importan mucho en la diplomacia.
Simplificar demasiado. Los modelos acortan los textos. Al hacerlo, pueden omitir el matiz que una Parte defendió durante tres sesiones.
No captan el ambiente. Un modelo no puede captar el ambiente ni la dinámica política de una negociación. No sabe qué se acordó en los pasillos.
Sin conocimientos expertos reales. Un modelo puede parecer experto en política climática sin serlo. Si te fías de él, puedes acabar con información incompleta o errónea.
Seguridad y privacidad. Las negociaciones suelen incluir información sensible. Todo lo que pegas en un servicio de IA en línea sale de tu delegación. Poca gente lee las condiciones que explican cómo se almacena.
Ética. Di con claridad cuándo usas IA. Mantén a las personas a cargo de las decisiones. Vigila el mal uso.
Malentendidos. Un modelo puede interpretar mal lo que le pediste. Puede darte un texto que parezca reflejar tu postura, pero que no lo haga.
Cómo usar los modelos
Qué modelo y en qué términos, cómo escribir una instrucción, y una biblioteca para copiar.
5.1Qué modelo y bajo qué condiciones
Hay dos tipos de asistentes de IA. El tipo que uses importa más que la marca.
Pesos cerrados. ChatGPT, Claude y Gemini funcionan en los ordenadores de las empresas. Accedes a ellos con una cuenta. Son los modelos más potentes y los más fáciles para empezar. Las versiones gratuitas pueden redactar, traducir y resumir. Las versiones de pago cuestan unos veinte dólares al mes. Permiten trabajar con documentos más largos y subir archivos, e incluyen las funciones de agente del capítulo 6. Todo lo que escribes llega a la empresa. Según tu configuración, la empresa puede guardarlo, permitir que su personal lo lea o usarlo para entrenar su próximo modelo.
Pesos abiertos. Llama, Mistral, Qwen, Gemma y DeepSeek publican sus modelos para que cualquiera los descargue. Así, tú, tu institución o un proveedor que elijas pueden ejecutarlos. Ollama instala uno en un portátil en pocos minutos. Polly, gestionado por GainForest y Youth Negotiators Academy en polly.ai4cop.org, es un modelo de pesos abiertos en línea que no guarda nada de lo que envías. El capítulo 11 explica cómo ejecutar el tuyo.
Una regla sencilla para empezar. Usa un modelo cerrado para material que ya sea público. Usa uno de pesos abiertos para lo demás. Nunca pegues una posición que tu delegación aún no haya presentado en un servicio que no controlas. El capítulo 10 explica lo que está en juego. Léelo antes de abrir una cuenta.
Elijas el que elijas, instala la aplicación móvil. La entrada por voz ayuda cuando caminas entre sesiones. Expresar una idea inicial en tu idioma suele dar un mejor borrador que escribir una frase cuidada en inglés.
5.2Lo básico para escribir instrucciones
La instrucción que escribes se llama prompt. Cuanto más claro y concreto sea tu prompt, mejor será la respuesta.
Un prompt puede tener hasta cuatro partes. No siempre las necesitas todas.
Instrucción. Lo que quieres que haga el modelo.
Contexto. Información que ayuda al modelo a dar una mejor respuesta.
Entrada. El texto, la pregunta o el documento con el que quieres que trabaje.
Formato de salida. Cómo debe ser la respuesta.
5.3Qué hace que un prompt sea bueno
Seis hábitos hacen gran parte del trabajo. Sirven para todos los modelos.
Sé claro y concreto. Di quién eres, qué quieres y cómo debe ser la respuesta. El modelo no sabe dónde estás ni qué pasa a tu alrededor.
Muestra un ejemplo. Una muestra de la respuesta que quieres funciona mejor que un párrafo que la describa.
Pide citas. Dile al modelo que cite el pasaje en el que se basa. Vincular una respuesta a un documento real es la mejor protección contra los datos inventados.
Etiqueta las partes. Pon cada parte entre etiquetas, como <contexto>, <tarea> y <texto>. Así el modelo puede distinguir tu instrucción del documento que pegaste.
Deja que piense primero. Pide el razonamiento antes de la respuesta. Los modelos cometen menos errores en tareas de varios pasos cuando los siguen uno a uno.
Dale un papel. "Investigas las pérdidas y los daños" suele dar una mejor respuesta que la misma petición sin un papel.
Luego sigue. Mejora el prompt y vuelve a preguntar. El segundo intento casi siempre es mejor que el primero.
Adopta un hábito desde el principio. Pide fuentes y pide al modelo que marque las partes de las que no está seguro. Si no puedes comprobar una respuesta, no puedes usarla en una sesión plenaria.
Las partes de una intervención
Los negociadores escriben intervenciones más que cualquier otra cosa. Un buen prompt para una intervención tiene cinco partes: quién habla y dónde, el tema concreto, las pruebas, el acuerdo con el que se vincula y lo que se debe hacer.
1Como delegado juvenil de Malasia en la COP29, redacta una intervención de dos minutos 2sobre las pérdidas y los daños que afectan a la infancia en Malasia. Destaca 3problemas como el aumento del nivel del mar que amenaza a las comunidades costeras, las interrupciones educativas por los efectos del clima y los problemas de salud mental infantil. 4Ofrece recomendaciones concretas para priorizar la financiación que proteja los derechos de la infancia y refuerce su participación en los debates sobre el clima 5en el marco del Acuerdo de París.
Si omites alguna parte, el borrador empeora. Sin el papel, no escribe para nadie. Sin las pruebas, escribe emociones en vez de hechos. Sin la última línea, no se vincula a ningún acuerdo que permita actuar.
5.4Prompts para distintos usos
- Análisis de datos
Con esta hoja de cálculo, grafica el aumento medio de las emisiones en los últimos años, indica tu método y enumera los supuestos que hiciste sobre los datos que faltan.
Configuración: Carga de archivos - Traducción
Traduce este párrafo al español y mantén el registro formal de los textos de las decisiones.
Configuración: Cualquier modelo - Resumen
Resume la intervención del Grupo de los PMA en el diálogo técnico del balance mundial del 10 de junio de 2023 y cita los pasajes en los que te basas.
Configuración: Búsqueda web activada - Preparar un discurso
Escribes los discursos de un negociador sobre el cambio climático de la ONU. Escribes sobre los esfuerzos del Reino Unido en materia de fomento de la capacidad. Soy el negociador. ¿Qué cinco preguntas me harías para obtener la información que necesitas para redactar una declaración?
Configuración: Cualquier modelo - Preparar contraargumentos
Las pérdidas y los daños son un tema clave en las negociaciones climáticas. Investigas las pérdidas y los daños. Enumera las principales razones por las que algunos países les dan poca prioridad. Luego escribe un contraargumento sólido que muestre por qué hace falta un fondo para pérdidas y daños.
Configuración: Cualquier modelo - Redactar una declaración o un discurso
Redactas discursos y estás preparando una declaración con las preguntas anteriores. Escribe una declaración de 300 palabras sobre los esfuerzos del Reino Unido en materia de fomento de la capacidad climática, con el estilo del Gobierno del Reino Unido.
Configuración: Cualquier modelo - Explicar términos técnicos
Explica qué significa "medios de aplicación" en este párrafo con palabras sencillas y da un ejemplo de cómo se ha usado la expresión en una decisión anterior.
Configuración: Cualquier modelo - Encontrar el documento
¿Qué texto de decisión contiene el mandato de este programa de trabajo? Dame la signatura del documento y cita el párrafo donde aparece.
Configuración: Recuperación de información - Traducir para un público local
Traduce esta intervención al malayo para un público comunitario, conserva el sentido y elimina los términos técnicos de la UNFCCC.
Configuración: Cualquier modelo
Agentes
Otra forma de trabajar: un encargo en lugar de una instrucción, y diez casos de uso para probar.
Hasta ahora todo ha funcionado igual. Escribes una petición, lees la respuesta y decides qué hacer con ella. Cuatro cambios han añadido otra forma de trabajar.
Los modelos pueden leer más. Un modelo ya puede leer a la vez un texto de negociación completo, sus versiones anteriores y tus notas informativas.
Los modelos pueden buscar. Un sistema puede buscar en un conjunto de documentos o en la web antes de responder y citar lo que encontró. Así puedes comprobar la respuesta.
Los modelos pueden usar herramientas. Un modelo puede conectarse a un buscador, una hoja de cálculo, un calendario o una carpeta de archivos. Así puede trabajar con ellos en vez de solo describirlos.
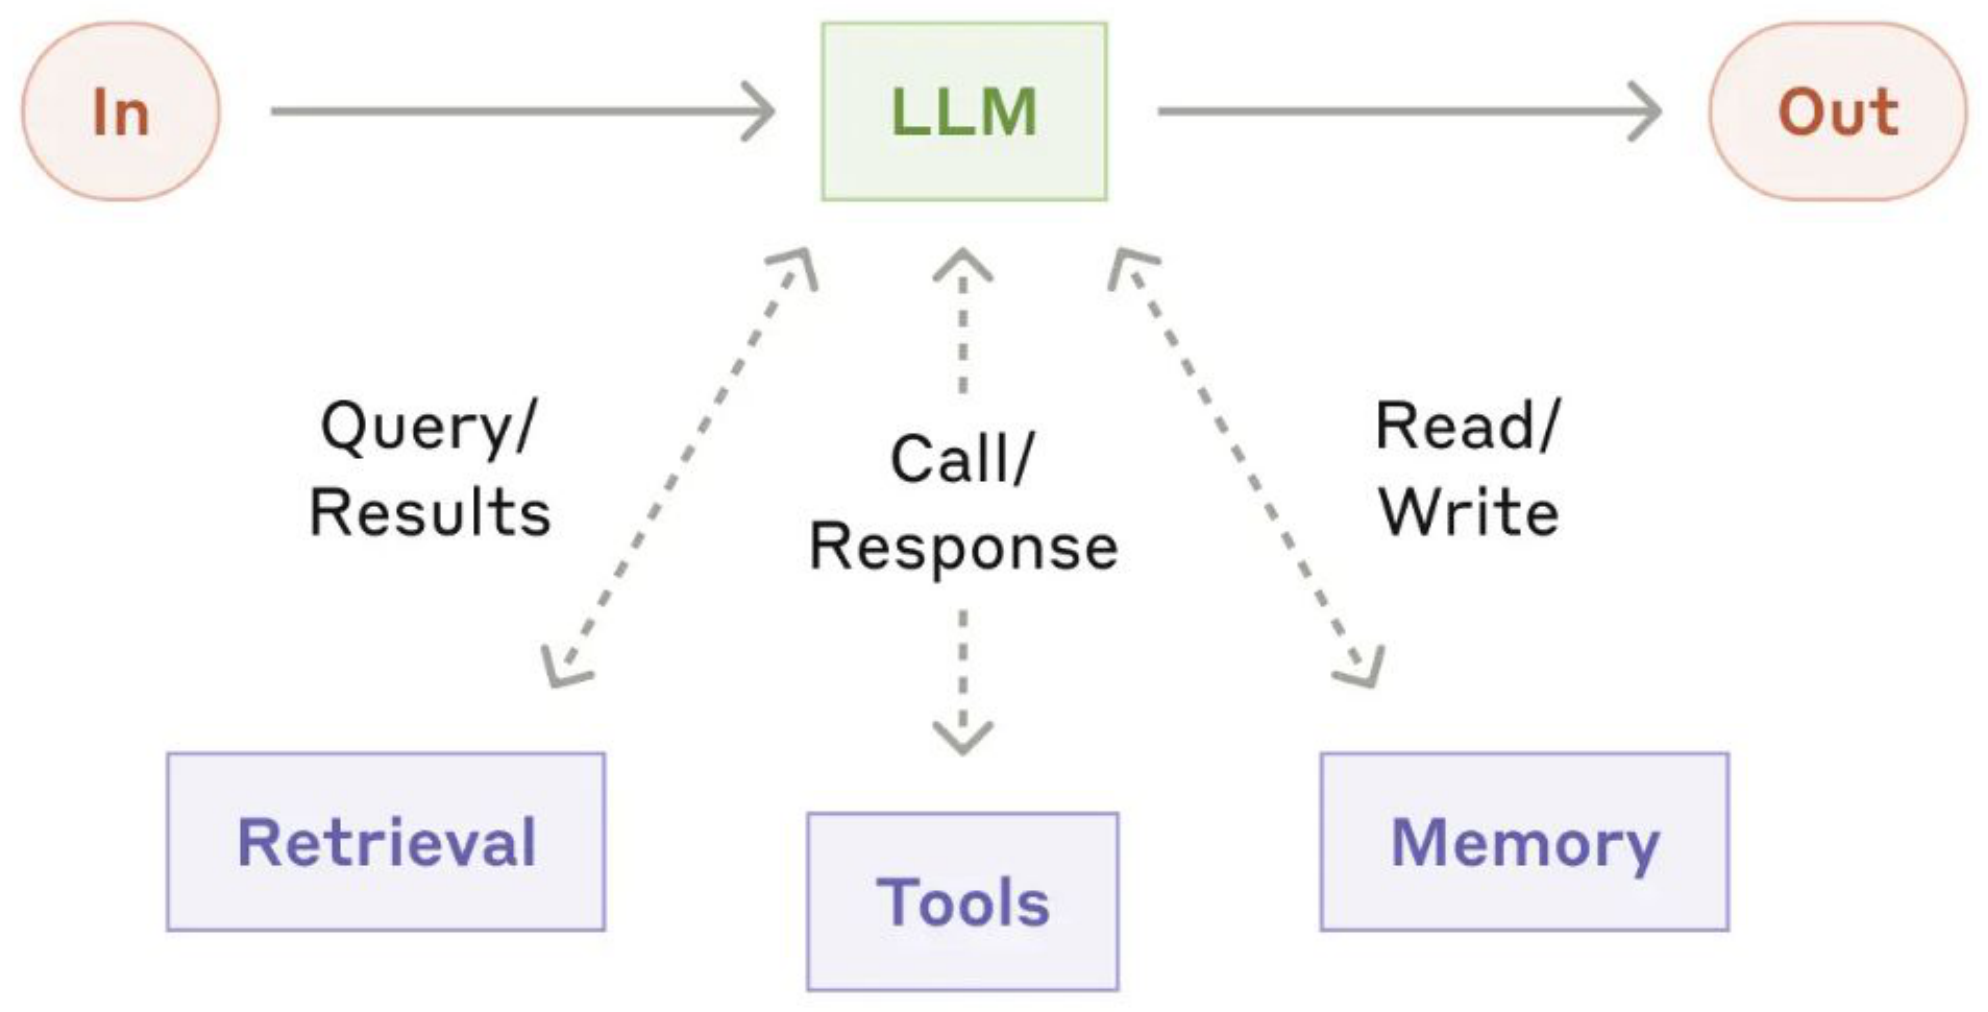
Los modelos pueden repetir. Un sistema ya no tiene que responder una vez y parar. Puede planificar, dar un paso, ver el resultado y volver a intentarlo hasta terminar la tarea.
Combina todo esto y tendrás lo que se llama un agente. Un agente es un modelo con herramientas y memoria que sigue trabajando hasta terminar una tarea. Actúa dentro de los permisos que una persona le dio. No tiene criterio ni puede rendir cuentas. Tiene una tarea y unos permisos, nada más.
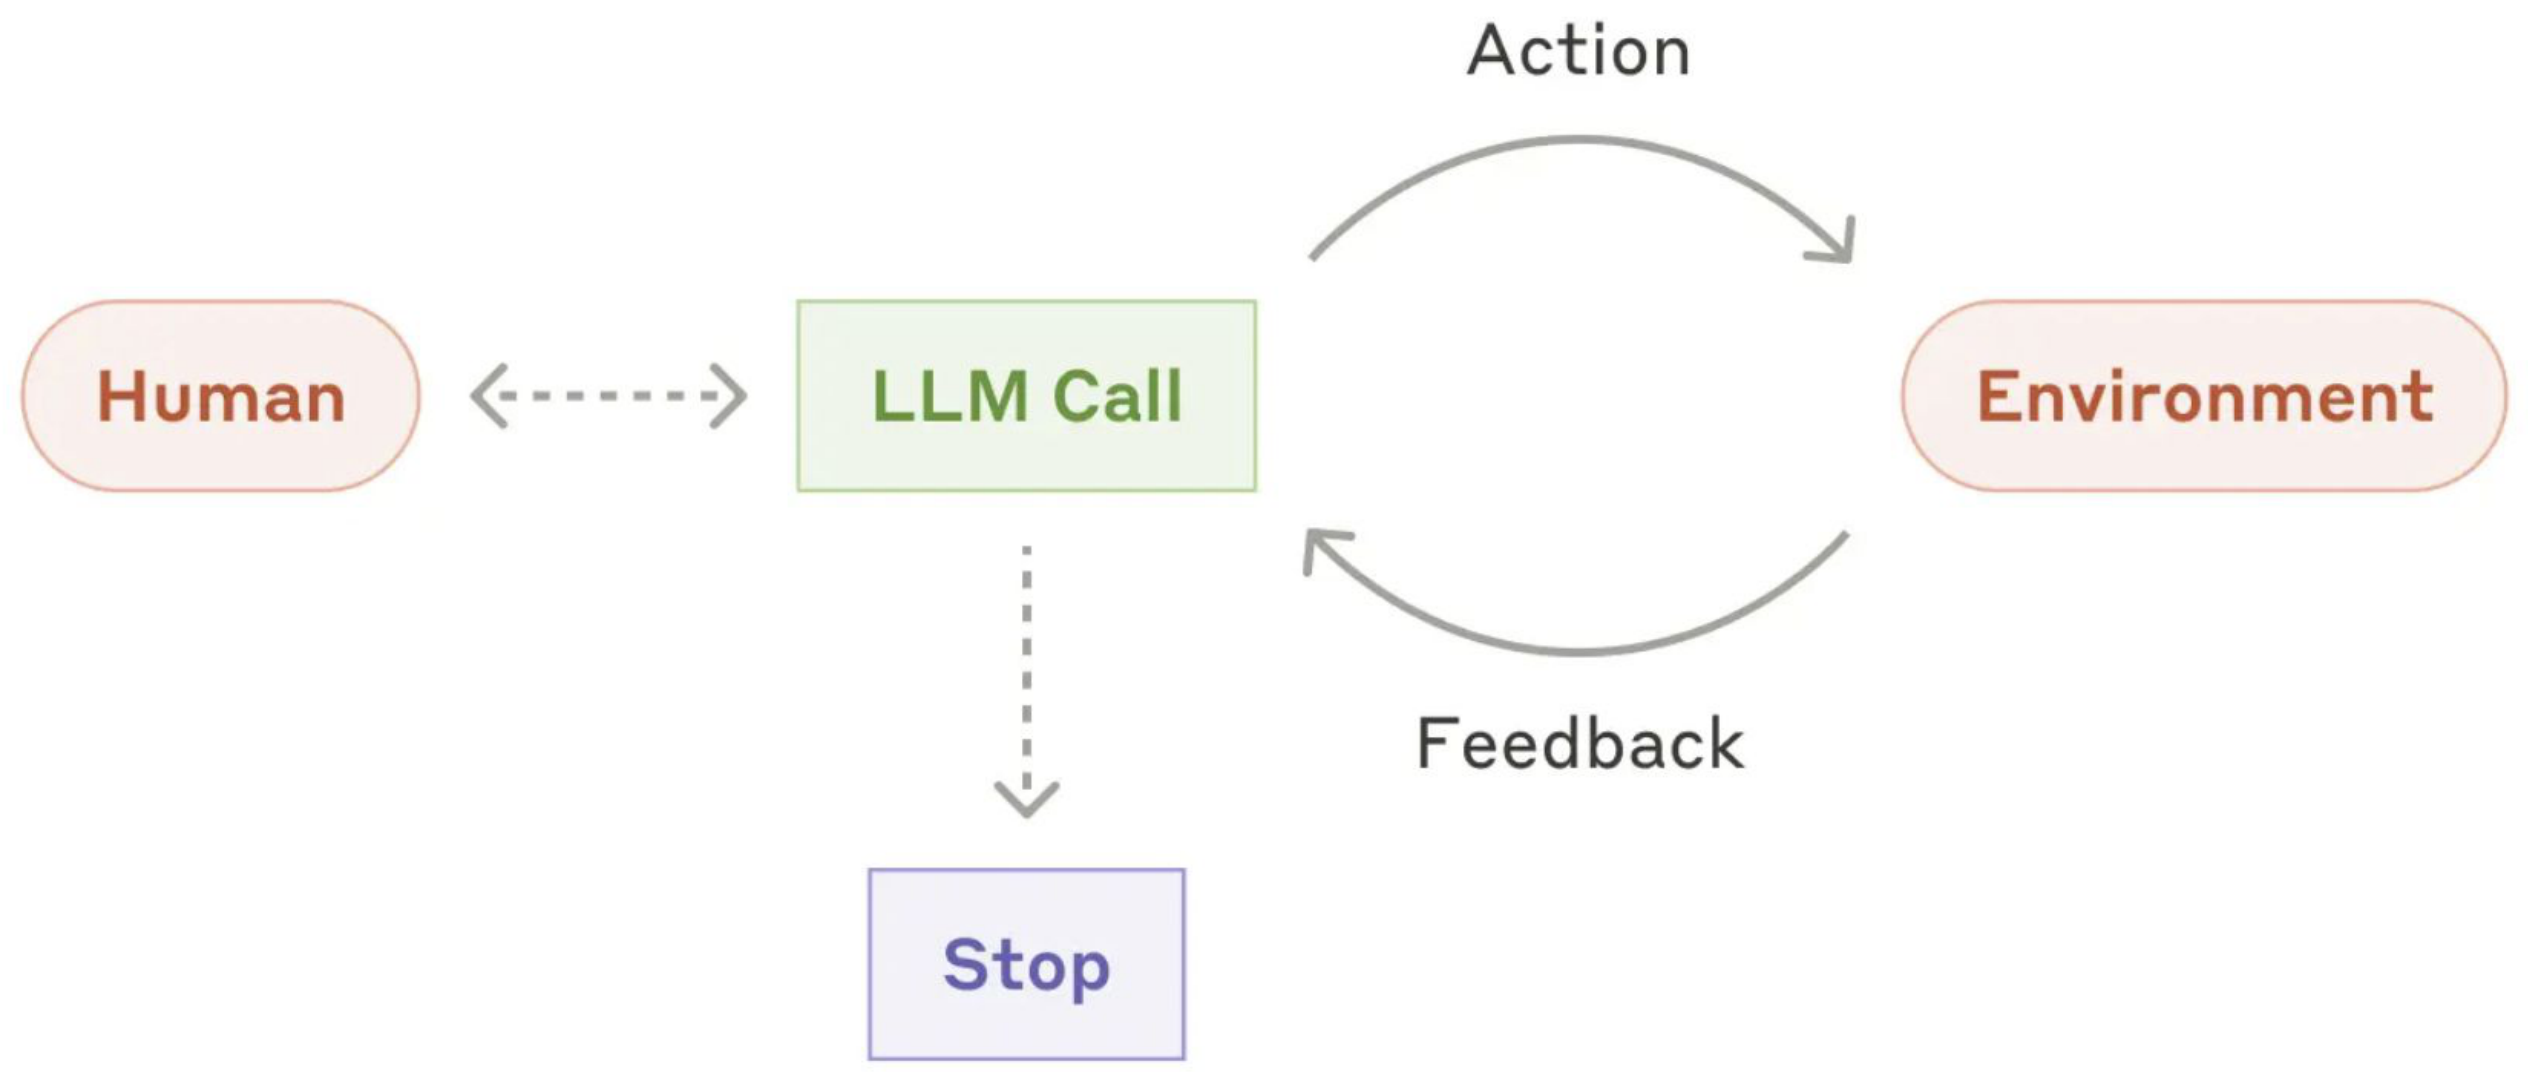
6.1Tres formas de trabajar
Chat. Tú preguntas, el sistema responde y tú compruebas. Sirve para redactar, traducir, explicar y practicar.
Búsqueda. El sistema busca primero en un conjunto fijo de documentos, luego responde y muestra sus fuentes. Úsalo para cualquier dato sobre la negociación: cómo cambió un texto, qué dijeron las Partes, decisiones anteriores.11Si un sistema te dice qué dice un párrafo de una decisión y no puede mostrarte el párrafo, trátalo como un rumor.
Agente. El sistema realiza una tarea en varios pasos con herramientas. Úsalo para tareas repetitivas cuyo resultado puedas comprobar, como seguir los cambios entre borradores o preparar un informe diario.
6.2Casos de uso
- Seguimiento de cambios en textos
Compara la revisión 3 de este proyecto de decisión con la revisión 2. Enumera cada cambio de fondo, cita ambas versiones y señala los cambios que afectan a las líneas rojas de mi delegación.
Configuración: Archivos adjuntos - Mapa de posiciones
A partir de estas comunicaciones, crea una tabla de las posiciones de las Partes sobre el artículo 6.4 con una cita y una referencia por fila. Marca cualquier posición que hayas deducido.
Configuración: Recuperación de información - Repaso histórico
Rastrea cómo se ha matizado la frase "responsabilidades comunes pero diferenciadas" en los textos de las decisiones desde 2015 y cita cada decisión.
Configuración: Recuperación de información - Lectura nocturna
Aquí están los cuatro textos publicados hoy. Dime qué avanzó, qué se estancó y qué tres páginas debo leer antes de mañana.
Configuración: Archivos adjuntos - Resumen diario
Cada tarde, reúne los textos publicados ese día en las líneas de negociación que sigo, resume qué cambió y envíame la lista.
Configuración: Agente programado - Lectura de corchetes
Para cada opción entre corchetes de este párrafo, explica a quién beneficia, quién se opone y cuál podría ser una formulación alternativa.
Configuración: Archivos adjuntos - Ensayo
Actúa como un negociador que se opone a este texto. Cuestiona mi intervención y no seas complaciente.
Configuración: Chat - Traducción inversa
Traduce mi formulación al francés, luego vuelve a traducirla al inglés de forma independiente y dime qué cambió de sentido.
Configuración: Chat - Traspaso
A partir de mis notas de este período de sesiones, redacta el documento de traspaso para quien se encargue de este tema en el próximo ciclo.
Configuración: Archivos adjuntos - Trabajo con datos
Con esta hoja de cálculo de emisiones, traza la tendencia de estos países desde 2010, explica tu método y enumera cada supuesto sobre los datos que faltan.
Configuración: Acceso a archivos
6.3Trabajar con un agente de forma segura
Cuando un chatbot te entiende mal, recibes un párrafo malo. Cuando un agente te entiende mal, puede actuar a partir del error.
Comprueba todo lo que vayas a repetir. Abre un documento citado y confirma que la cita está ahí antes de usarla en la sala.
Da el mínimo de permisos posible. Un sistema que lee tus archivos no necesita también enviar correos.
No te fíes de documentos externos. Un archivo que otra persona haya enviado puede contener instrucciones ocultas dirigidas al agente.
Decide quién da el visto bueno. Acordad quién aprueba los textos escritos con ayuda de la IA. Cuando intervienen varias herramientas, nadie más lo hará.
Agentes para correos electrónicos
Triaje del correo, redacción y seguimiento, delegados con cuidado.
El correo electrónico sigue siendo el principal medio de comunicación profesional. Tres cosas lo dificultan.
Volumen. Las bandejas de entrada se llenan, y ordenar los mensajes lleva un tiempo que no tienes.
Escribir bien. Redactar un correo claro y breve que lleve a actuar requiere habilidad.
Idiomas. A menudo tienes que escribir en un idioma que no es el tuyo.
Un asistente conectado a tu buzón puede leer toda la conversación por sí solo. Dale permiso para leer y redactar borradores. Encárgate tú de enviarlos.
- Seguimiento de reuniones
Resume los puntos clave y los compromisos de la reciente reunión de negociación, indica quién asumió cada uno y redacta un correo de seguimiento cortés para los asistentes sobre las acciones acordadas.
- Programar reuniones
Escribe un correo cortés y flexible que proponga varias fechas y horas para la próxima ronda de reuniones, en la zona horaria de cada participante.
- Informe diario
Escribe un breve informe diario por correo sobre los avances en las últimas sesiones: nuevas propuestas, puntos acordados y puntos aún en disputa.
- Fijar prioridades
Escribe un correo al equipo de negociación que proponga cómo ordenar los temas del programa según su urgencia, su impacto en los objetivos climáticos y la posibilidad de acuerdo.
- Ordenar la bandeja de entrada
Agrupa mis mensajes sin leer en: requiere una decisión mía, requiere respuesta, requiere reenvío, no requiere nada. Redacta respuestas solo para el tercer grupo y déjalas sin enviar.
- Revisar el tono
Reescribe este correo en lenguaje diplomático formal sin cambiar ningún compromiso sustantivo, y luego enumera los cambios para que pueda revisarlos.
Estos sistemas suelen escribir con un tono cálido y amable. Ese tono puede hacer concesiones que tu texto original no hacía. Pregunta al modelo qué cambió y lee la lista.
Agentes para la logística
Calendarios, listas de control y viajes. El trabajo de bajo riesgo que los agentes hacen bien.
Durante un período de sesiones, los horarios, las listas de tareas y las reservas de viaje se acumulan rápido. Tres problemas se repiten una y otra vez.
Tiempo. Decidir qué hacer primero y cuánto tiempo dedicarle es difícil.
Tareas olvidadas. Se olvidan cosas importantes de la lista.
Viajes. Encontrar vuelos y hoteles que se ajusten a tu horario y presupuesto lleva horas.
Este es el trabajo de menor riesgo de la guía y el mejor punto de partida para usar un agente. Las tareas se repiten, puedes comprobar los resultados fácilmente y muy poca información es confidencial.
- Reservas
Busca los vuelos y hoteles más baratos y convenientes para un viaje de [ciudad de salida] a [ciudad de destino] en [fechas]. Prefiero vuelos por la mañana y un hotel cerca de la sede. Muéstrame las ventajas y desventajas de las opciones en vez de una sola recomendación.
- Listas de tareas
Haz una lista completa para un período de sesiones internacional de dos semanas: documentos, acreditación, ropa para un clima cambiante, equipo de trabajo y copias de los textos clave para consultar sin conexión.
- Planificar el día
Revisa mi calendario y el programa del período de sesiones. Luego propón un horario con reuniones, tiempo para mi propio trabajo, ejercicio y tiempo personal, teniendo en cuenta estos plazos y compromisos.
- Seguir los avances
Haz una plantilla para seguir las líneas de trabajo que sigo, con hitos, plazos y espacio para novedades y próximos pasos.
En la logística también darás por primera vez a un agente acceso real a tu calendario, correo y archivos. Está bien. Pero ahí también empieza el hábito de dar un poco más de acceso cada vez. El sistema que reserva tus vuelos no necesita redactar tus posiciones.
Agentes para otras actividades
Bienestar, cultura y el lado humano de una sesión, con límites honestos.
Las negociaciones climáticas implican tanto personas como hechos. Las emociones, las diferencias culturales y la salud mental también influyen.
Salud mental. El cambio climático y la presión de negociar desgastan a los delegados.
Malentendidos culturales. Las personas de distintas culturas pueden malinterpretarse. Eso causa roces y retrasa las conversaciones.
En esta única parte de la guía, una simple ventana de chat es mejor que un agente. Son conversaciones. No necesitan un sistema con acceso a tus archivos.
- Resumen cultural
Estoy en una negociación sobre el cambio climático de la ONU con alguien de Kenia. ¿Qué aspectos culturales debo tener en cuenta para avanzar en mi negociación?
- Un poco de ánimo
Ahora mismo estoy desanimado, ¿puedes decirme algo que me anime?
- Repaso de la sesión
Esto es lo que pasó en esa sesión y cómo lo manejé. ¿Qué habría hecho de otra manera un negociador con más experiencia?
Dos advertencias. Primero, un resumen cultural describe un país en general, pero tú hablarás con una persona. Úsalo como contexto, no como predicción. Segundo, un modelo sirve para expresar una idea a la una de la madrugada. Pero no es un médico ni un colega, y no es confidencial. Si sientes algo más que cansancio, habla con tu jefe de delegación, los contactos de apoyo de tu programa o un profesional.
Soberanía y a quién pertenece qué
De quién son las palabras, los datos y las decisiones cuando hay un modelo en la sala. Una página.
Estas herramientas pueden equilibrar las condiciones en las negociaciones multilaterales. Reducen la barrera del idioma que decide quién habla con confianza. Acortan documentos que nadie tiene tiempo de leer. Dan a una delegación de dos personas parte del alcance de una de cincuenta. Eso es valioso. Pero antes de escribir, hazte unas preguntas.
¿A quién pertenecen los datos? El texto que pegas en un asistente en línea sale de tu delegación. Según la cuenta y su configuración, la empresa puede guardarlo, dejar que su personal lo lea o usarlo para entrenar su próximo modelo. Las posiciones nacionales, las instrucciones de tu capital y todo lo que te hayan contado en confianza no deben estar ahí.
¿A quién pertenece la decisión? Un modelo escribe texto que parece una posición. Si redacta y nadie revisa, el razonamiento que sustenta la posición de tu país empieza a ocurrir fuera de tu delegación. Cada texto que salga debe tener un responsable con un mandato.
¿Qué no puedes ver? OpenAI y Anthropic no te muestran el razonamiento completo del modelo. Recibes una respuesta y, a veces, un resumen de cómo llegó a ella. Los pasos reales se quedan en la empresa. No puedes comprobarlos, repetirlos ni mostrar a un colega por qué el sistema dijo lo que dijo.
¿Pesos abiertos o cerrados? Los pesos de un modelo son los números que aprendió durante el entrenamiento. ChatGPT, Claude y Gemini guardan los suyos en los ordenadores de sus empresas. Son los modelos más potentes y los más fáciles de usar. Llama, Mistral, Qwen, Gemma y DeepSeek publican los suyos, así que puedes ejecutar el modelo en tu propio ordenador o en un servidor de tu región. Los modelos abiertos traducen, resumen y redactan bien. Son menos capaces ante los problemas más difíciles que requieren varios pasos. Y si tienes los pesos, nadie puede subir el precio ni apagar el modelo en plena sesión.
Una IA que respeta la soberanía implica que la delegación, región o comunidad fija las condiciones. Eligen qué modelo usar, qué datos introducir y quién puede comprobar lo que hizo. También pueden decir que no. En el proceso de la COP, las Partes con menos capacidad suelen ser las que más se juegan. Así que esta es una cuestión práctica.
Una regla práctica. Usa el modelo en línea más potente para material público, lecturas de contexto, redacción y práctica. Para cualquier asunto sobre una posición que aún no sea pública, usa un modelo de pesos abiertos o un servicio con un contrato que tu institución haya leído.
Esta guía existe para que tengas presente ese equilibrio. Los capítulos anteriores muestran lo que estos sistemas hacen bien. Este muestra lo que cedes a cambio.
Poner en marcha tu propia IA soberana
Ejecutar usted mismo un modelo de pesos abiertos: qué correr, cuánto cuesta el hardware y cómo montarlo.
El capítulo anterior expuso el dilema. La mejor respuesta es ejecutar el modelo por tu cuenta.
Cuando alojas tu propio modelo, nada sale del edificio. No tienes que confiar en la política de datos de una empresa. Las condiciones de servicio no pueden cambiar sin que tú decidas. Nadie puede suspender tu cuenta en plena sesión. Y tu institución desarrolla esa capacidad en vez de alquilarla.
Hasta hace poco, ejecutar tu propio modelo implicaba conformarte con uno mucho menos capaz. Eso ya no es así.
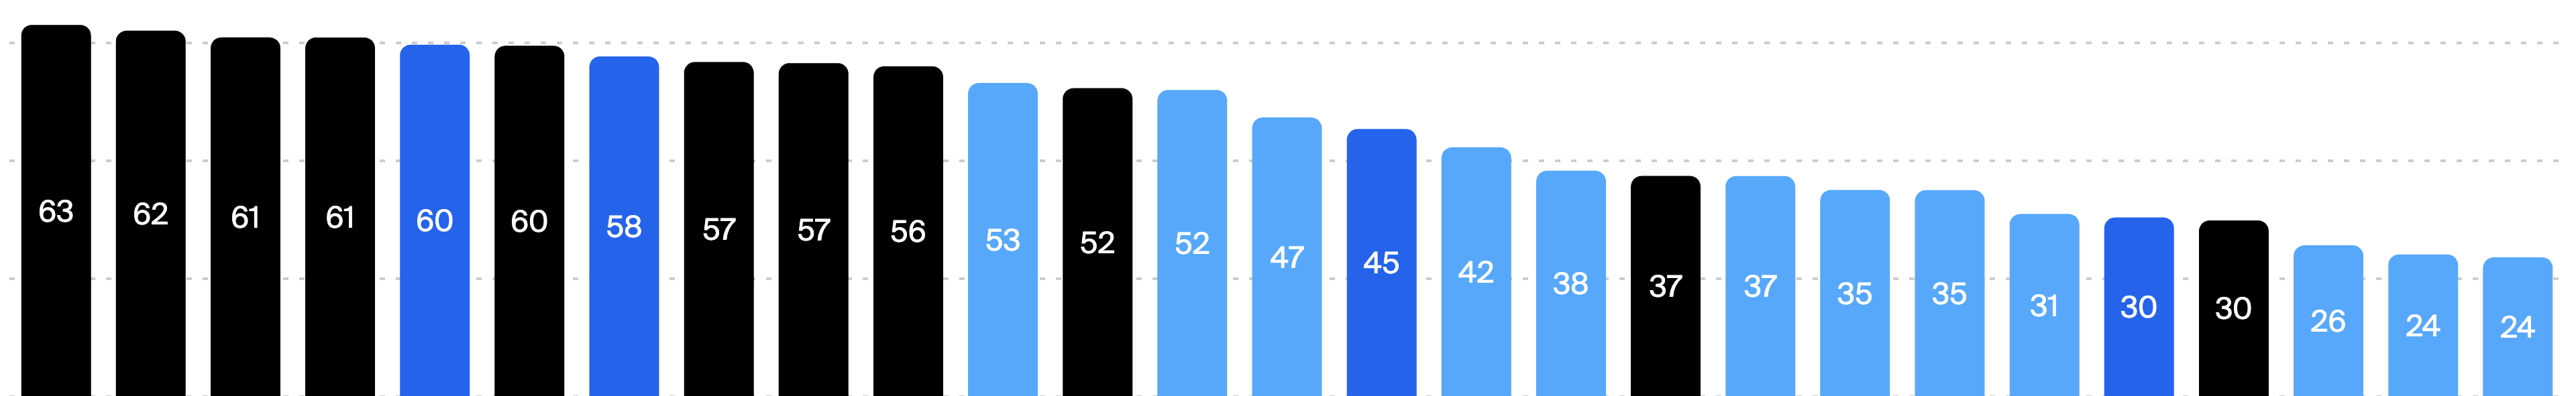
Artificial Analysis publica un índice de inteligencia que puntúa los modelos con las mismas pruebas. Kimi K3 y GLM-5.3 obtienen 60 puntos, tres menos que Claude Opus 5, con 63. Qwen3.8 les sigue con 58. Diecinueve de los 29 modelos del índice tienen pesos abiertos, aunque los modelos cerrados aún ocupan la mayoría de los primeros puestos.11El gráfico cuenta GLM-5.3 y GLM-5.3-Flash como modelos propietarios. Z.ai publica ambos conjuntos de pesos con una licencia MIT, así que este libro los cuenta como abiertos. Por eso la figura muestra diecisiete barras azules y el texto dice diecinueve. Hace un año, el mejor modelo abierto estaba trece puntos por detrás del mejor modelo cerrado. La brecha se ha reducido rápido y puede reducirse más.
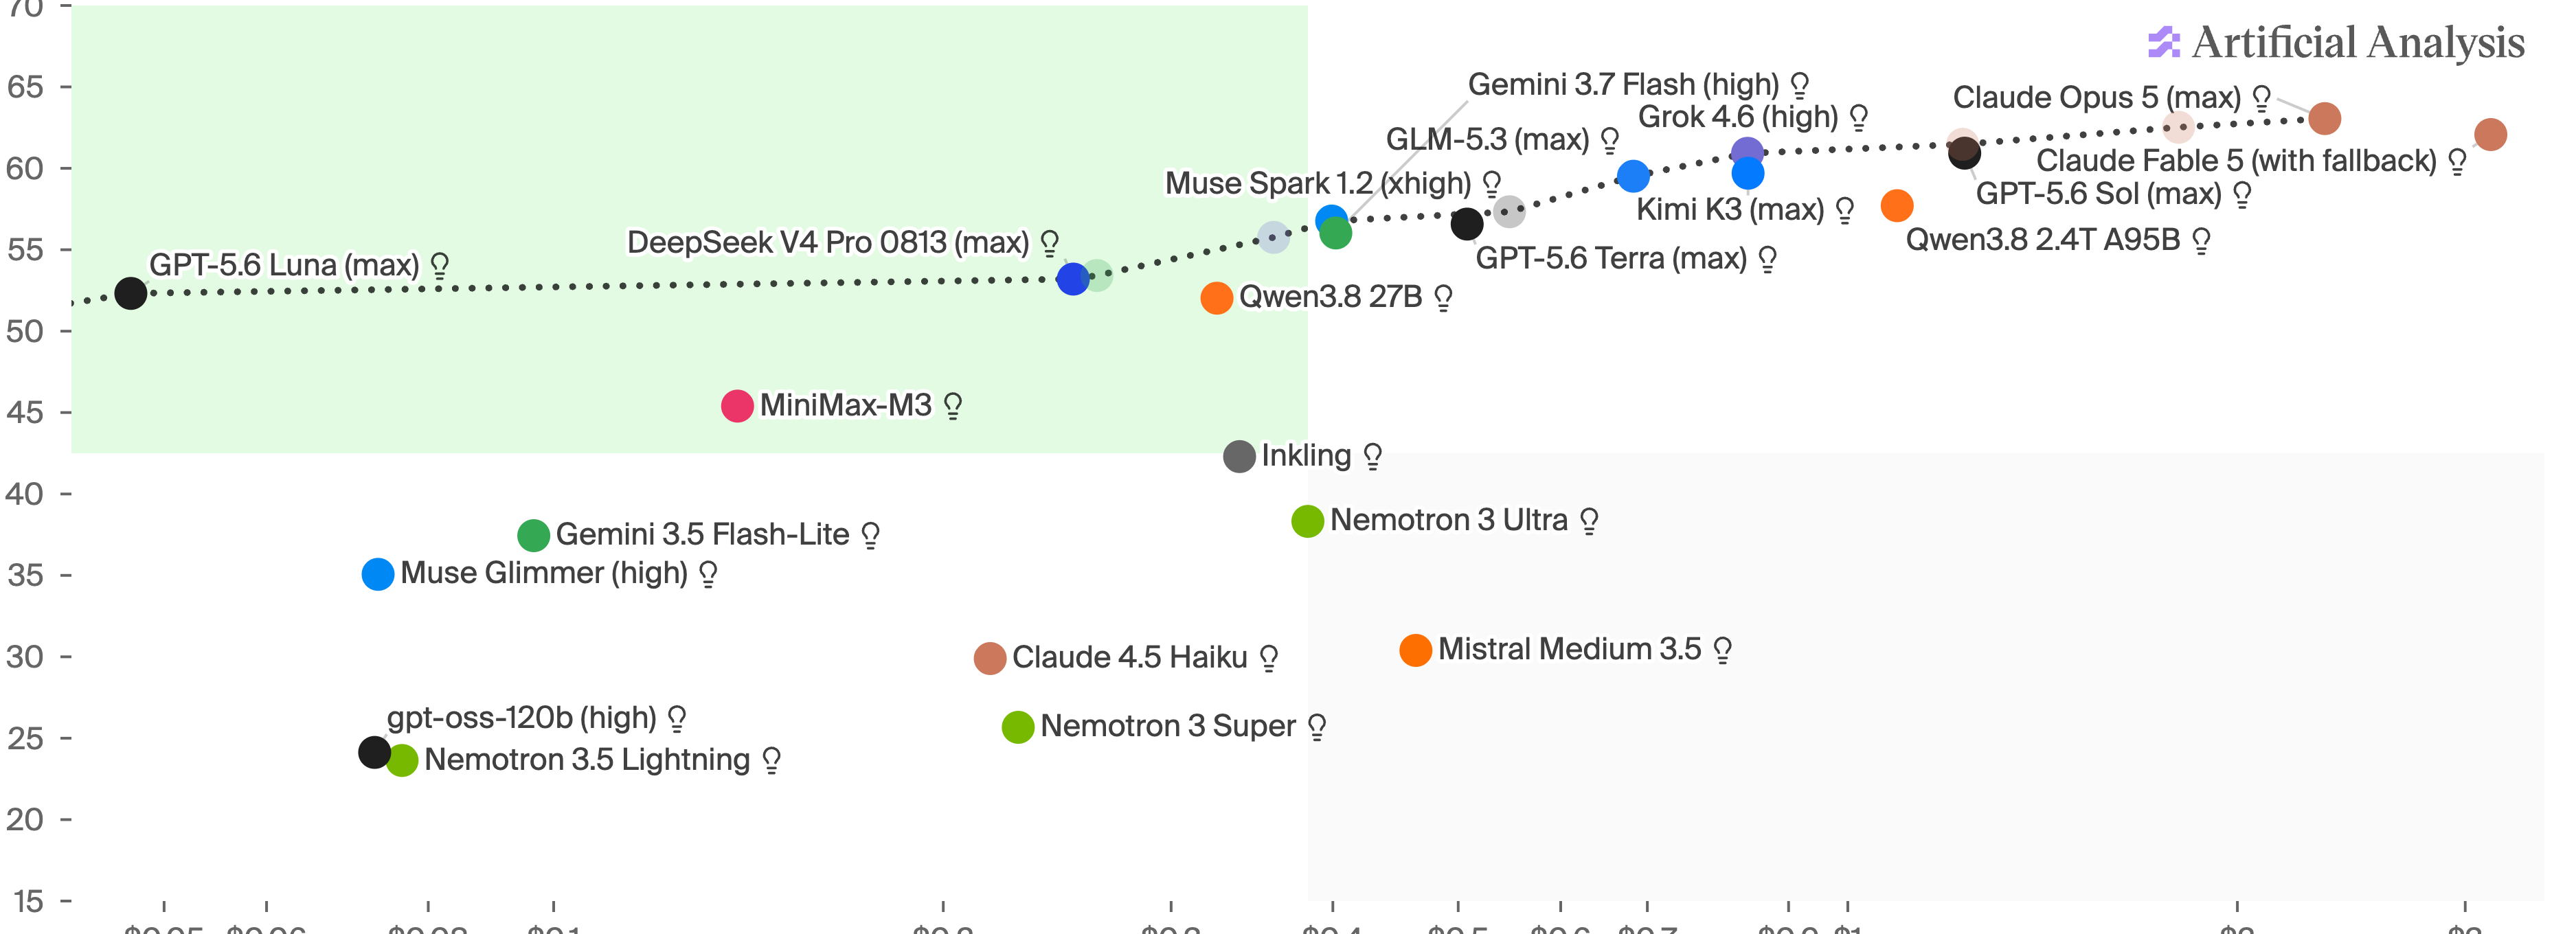
El precio es la otra mitad del argumento. GLM-5.3-Flash obtiene 57 puntos por unos nueve centavos por tarea. DeepSeek V4 Pro 0813 obtiene 53 por cerca de un cuarto de dólar. Ambos están en la esquina de alta puntuación y bajo coste. Claude Opus 5 obtiene 63, pero cuesta unas diez veces más que DeepSeek. Esa diferencia permite a una delegación costear su propio modelo.
11.1Qué modelo usar
| Modelo | Laboratorio | Pesos | Índice |
|---|---|---|---|
| Kimi K3 (max) | Moonshot | Abiertos, uso restringido | 60 |
| GLM-5.3 (max) | Z.ai | Abiertos, MIT | 60 |
| Qwen3.8 2.4T A95B | Alibaba | Abiertos, uso restringido | 58 |
| GLM-5.3-Flash | Z.ai | Abiertos, MIT | 57 |
| DeepSeek V4 Pro 0813 | DeepSeek | Abiertos | 53 |
| Qwen3.8 27B | Alibaba | Abiertos | 52 |
| MiniMax-M3 | MiniMax | Abiertos, uso restringido | 45 |
| Nemotron 3 Super | NVIDIA | Abiertos | 26 |
| gpt-oss-120b (high) | OpenAI | Abiertos | 24 |
Datos al 26 de agosto de 2026. Lee la licencia antes de elegir. Varios de los modelos abiertos más capaces limitan el uso comercial. Para una delegación, eso no suele ser un problema. Para una empresa que crea un producto basado en uno de ellos, sí lo es.
11.2Cuánto cuesta
Un NVIDIA DGX Spark es un ordenador de sobremesa con 128GB de memoria. Hoy cuesta 4.699 dólares. Puedes conectar dos directamente entre sí para tener 256GB por unos 9.400 dólares. Ese par puede ejecutar un modelo grande como DeepSeek a entre 55 y 60 tokens por segundo, más rápido de lo que puedes leer. También puede contener cerca de un millón de tokens de texto a la vez, unas cuantas miles de páginas. Eso basta para el trabajo de una delegación.
Una unidad puede ejecutar un modelo más pequeño (de 27 a 35 mil millones de parámetros) con suficiente rapidez para sesenta personas a la vez. Eso cubre la traducción, los resúmenes y la redacción de toda una oficina. Tres o cuatro unidades, con entre 384 y 512GB, pueden ejecutar los modelos abiertos más grandes al completo.
Compáralo con pagar una suscripción por cada delegado. El equipo se amortiza en uno o dos ciclos de negociación y sigue funcionando cuando se acaba la financiación.
11.3Cómo configurarlo
Ejecuta el modelo con un programa llamado vLLM o SGLang. Ambos funcionan igual que el servicio de OpenAI. Así, cualquier herramienta que funcione con ChatGPT funcionará con tu propio servidor cuando cambies la dirección y la clave. Para una primera prueba en un portátil, Ollama o llama.cpp son más fáciles de usar. NVIDIA publica guías de configuración del Spark, y las guías públicas de la comunidad explican cómo conectar dos, tres o cuatro unidades.
Si no puedes ejecutar tu propio modelo antes del próximo período de sesiones, usa un servicio en línea que haya firmado un acuerdo de retención cero de datos. Es un compromiso escrito de no guardar lo que envías. Úsalo como solución temporal.
11.4Una limitación que conviene conocer
El índice anterior promedia nueve pruebas distintas, y los modelos abiertos no se quedan atrás por igual en todas. La brecha es mayor en las tareas de razonamiento más difíciles y en las alucinaciones. En ambas, los modelos cerrados siguen claramente por delante. Para quien negocia, lo que más importa son las alucinaciones. Por eso, dale al modelo tus propios documentos, pide fuentes y ábrelas.
IA cívica
Usar un modelo para escuchar a toda una circunscripción. Las herramientas que ya lo hacen y sus límites.
El capítulo anterior terminó con un modelo que funciona en tu propio equipo. Este trata de cómo usarlo para escuchar a tu gente.
Hasta ahora, esta guía ha tratado la IA como una herramienta que una persona usa para su trabajo. Hay un segundo uso. Cambia lo que puede hacer una delegación pequeña o un grupo de jóvenes. Un modelo puede ayudarte a escuchar a mucha más gente que un equipo humano. Luego puedes llevar lo que dijeron a la sala, con las pruebas adjuntas.
Esto se llama escucha a gran escala. Una encuesta encaja a las personas en respuestas que escribió alguien más. La escucha a gran escala funciona al revés. Las personas responden con sus propias palabras. Un programa encuentra patrones en las respuestas. Luego devuelve esos patrones a quienes las escribieron, para que puedan corregirlos.
12.1Polis, la más antigua de estas herramientas
Polis es una encuesta que funciona como una conversación. Las personas escriben afirmaciones breves. Los demás votan si están de acuerdo, en desacuerdo o prefieren pasar ante afirmaciones elegidas en parte al azar. El sistema agrupa a los votantes según sus votos. Luego destaca las afirmaciones en las que coinciden personas de todos los grupos, en lugar de las que logran una mayoría simple.
Taiwán es el ejemplo más conocido. Tras las protestas del movimiento Girasol de 2014, la comunidad de tecnología cívica g0v y el gobierno llevaron a cabo un proceso llamado vTaiwan en Polis. Más de 200,000 personas participaron en sus consultas. Una consulta sobre aplicaciones de transporte como Uber encontró afirmaciones con las que coincidían conductores, empresas de taxis y pasajeros. La normativa se redactó a partir de esas afirmaciones.
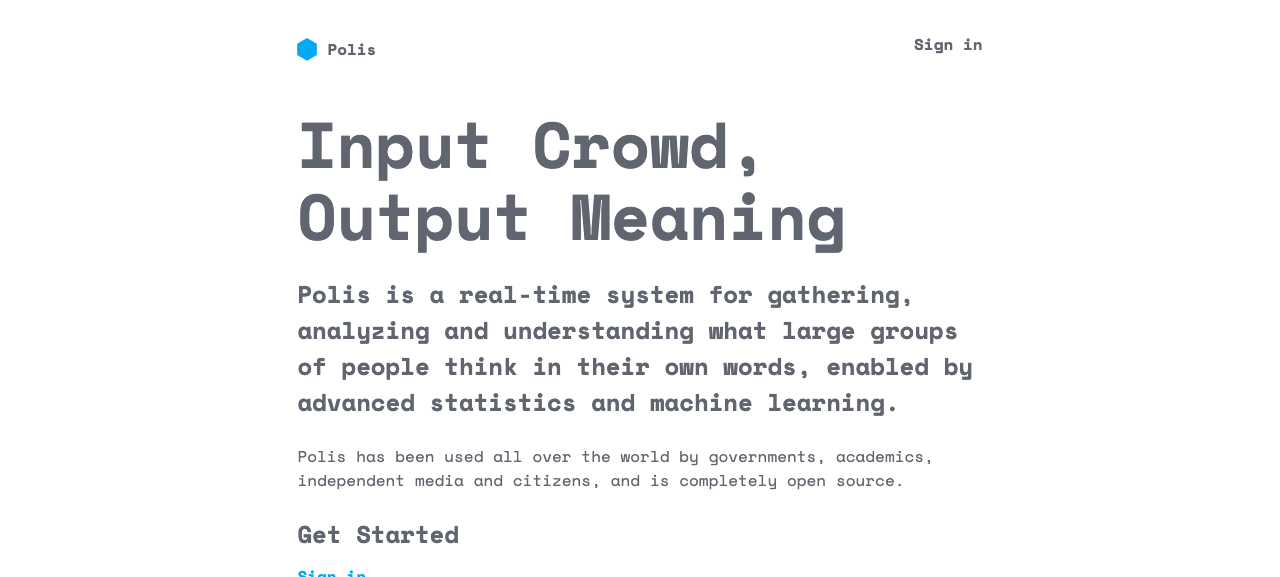
Polis es gratuito y de código abierto (licencia AGPL). Lo mantiene Computational Democracy Project. Es anterior a los modelos de lenguaje actuales y no usa ninguno. Esa es una de las razones por las que sigue funcionando bien.
12.2Talk to the City y lo que aportaron los modelos
Talk to the City añade un modelo de lenguaje que se encarga de leer. Lo creó AI Objectives Institute. Recibe entrevistas, respuestas a encuestas, publicaciones en foros o transcripciones. Las divide en afirmaciones individuales, las ordena por temas y escribe un informe. Cada línea del informe enlaza con la cita de la que procede. Las versiones más recientes también realizan las entrevistas. Hacen preguntas de seguimiento como lo haría una persona, en lugar de leer una lista fija.11Un proyecto usó un moderador de IA para entrevistar a 81,000 personas de todo el mundo. El modelo hacía preguntas de seguimiento sobre lo que planteaba cada participante. Esa escala es real, al igual que la salvedad que se explica más adelante: el modelo decide qué preguntar y qué conservar.
Esos enlaces a la fuente son lo que importa. Un resumen que nadie puede comprobar es solo una afirmación. Talk to the City es de código abierto (licencia Apache) y puedes ejecutarlo por tu cuenta.
12.3Team Mirai, la versión con escaños en el parlamento
Takahiro Anno es ingeniero de software y escritor de ciencia ficción. En 2024 se presentó a gobernador de Tokio sin partido y obtuvo 154,000 votos. Durante una transmisión en directo de diecisiete días, un avatar de IA entrenado con su programa electoral respondió a 8,600 preguntas de votantes. En mayo de 2025 fundó un partido, Team Mirai. Ganó un escaño en la cámara alta ese julio y once en la cámara baja en febrero de 2026, con cerca del siete por ciento de los votos.
El sistema que hay detrás es la parte que merece la pena copiar. Una persona habla con un entrevistador de IA. Este hace preguntas de seguimiento y convierte la conversación en un borrador de propuesta política. El partido solo recibe el borrador si la persona confirma que dice lo que quería expresar. Cuando suficientes personas apoyan una idea, se convierte en una propuesta que los legisladores del partido pueden presentar. En una consulta, el entrevistador recogió más de 1,200 horas de conversación en pocos días. Un entrevistador humano necesitaría unos cincuenta días sin dormir para hacer lo mismo.
Dos decisiones de diseño son clave. Primero, la persona da la aprobación final, así que el modelo no puede cambiar a escondidas lo que quiso decir. Segundo, el partido no toma partido en cuestiones que dividen profundamente a la sociedad. Las somete a votación directa, porque ningún programa puede hacer desaparecer un conflicto de intereses real.
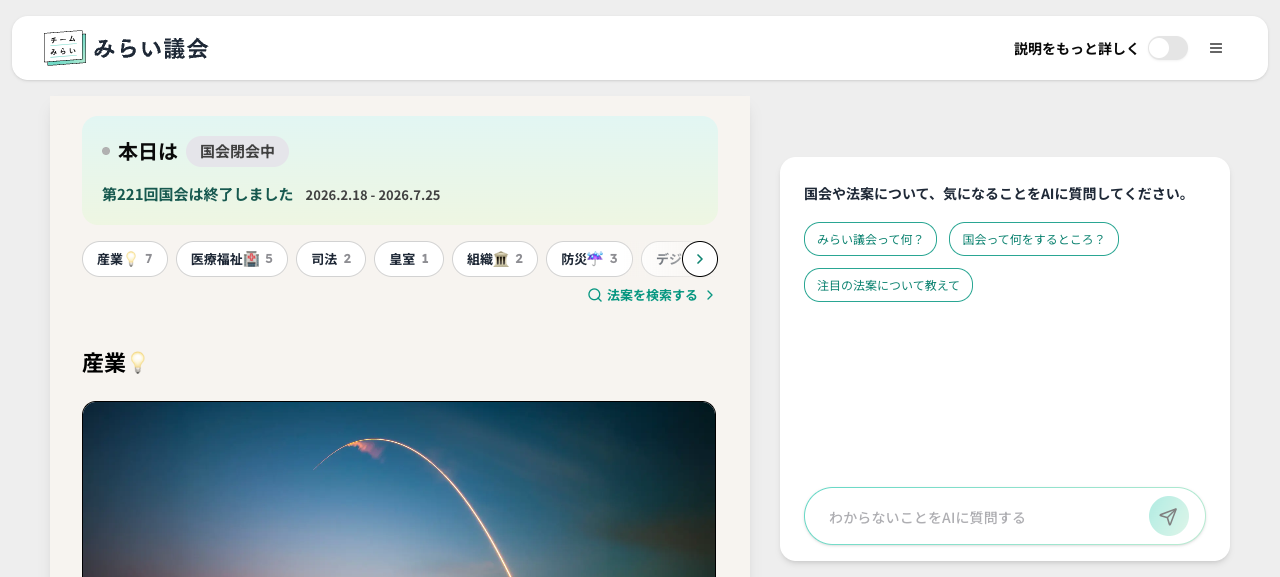
Su programa de escucha a gran escala, kouchou-ai, es de código abierto. Empezó como una versión de Talk to the City adaptada a los gobiernos municipales de Japón. Para una delegación, es mejor adaptar una herramienta pública existente a las necesidades locales, de forma abierta, que pagar a alguien para crear una nueva.
12.4Otras tres que conviene conocer
Agora Citizen Network. Una versión de código totalmente abierto que agrupa a las personas al estilo de Polis, creada para la web abierta. Está pasando al AT Protocol, un estándar abierto para datos sociales. Así, una discusión no queda encerrada en la base de datos de una empresa. En septiembre de 2025, durante la huelga bloqueemos todo, un equipo francés organizó una consulta nacional con ella. Querían ver si un país enfadado aún podía encontrar afirmaciones en las que coincidiera la gente.
Habermolt. Un experimento de investigación que va en otra dirección. No intenta escuchar a más gente. En cambio, da a cada persona un agente de IA que aprende sus opiniones y debate por ella en reuniones a las que nunca asiste. Lees lo que dijo tu agente y lo corriges. Se basa en Habermas Machine de DeepMind. Es una pregunta abierta, no una herramienta terminada. Un agente que habla por ti es justo aquello con lo que el capítulo 10 te advierte que tengas cuidado.
Simocracy. La creó GainForest, que coedita esta guía. Así que lee esto como un ejemplo, no como una recomendación. Cada participante escribe un "sim". Un sim tiene un avatar, una constitución que dice qué defiende y cuáles son sus líneas rojas, y una forma de hablar. El sim se guarda en el AT Protocol, pertenece a quien lo escribió y asiste a reuniones en su nombre. Los grupos debaten propuestas en público, dejando constancia, y deciden cómo repartir un presupuesto compartido. Se ha usado con Funding the Commons en Frontier Tower, en San Francisco, y en el experimento Agent Village. En ambos casos, las personas tomaron la decisión final sobre la financiación.
12.5Para qué sirve esto en una COP
Una posición del grupo. YOUNGO, el grupo de jóvenes, tiene cientos de miembros en todos los husos horarios y pocos días para acordar una postura común. La escucha a gran escala sustituye una llamada a la que nadie puede sumarse por un texto que todos pueden revisar.
Una convocatoria de aportaciones. El plazo de presentación cierra con 180 documentos y ninguna delegación los ha leído. Agrupa las afirmaciones, conserva las citas y abre los que importan.
Una delegación de dos personas. A menudo hay una distancia entre tu mandato y lo que la gente de tu país quiere de verdad. La escucha a gran escala reduce esa distancia, a bajo coste, entre sesiones.
Informar de los resultados. Tras una sesión, realiza el mismo proceso al revés. Explica qué se decidió y qué significa a nivel local, y escucha lo que dice la gente al respecto.
12.6Qué comprobar antes de usarlas
¿Quién escribió las preguntas? Un modelo que realiza entrevistas decide qué preguntar, qué conservar y cómo comunicarlo. Eso le da un poder real sobre el resultado. Publica la instrucción y la lista de temas, igual que publicarías un cuestionario.
Los participantes revisan sus propias palabras. Nada pasa al registro hasta que quien lo dijo confirma el resumen. Esta regla impide que una máquina ponga palabras en boca de la gente.
Idioma. Estas herramientas funcionan en los idiomas que la gente habla de verdad. Esa es su gran ventaja frente a una consulta solo en inglés. Comprueba los resultados en cada idioma. No traduzcas todo al inglés primero.
No inventes personas a las que podrías preguntar. Los participantes generados por IA son baratos y no valen como prueba. Si un grupo se ve afectado, gasta el dinero en llegar a él.
Aloja tú mismo el material sensible. Polis, Talk to the City, kouchou-ai, Agora y Simocracy son de código abierto. El capítulo 11 explica cómo ejecutarlos en tu propio equipo.
La huella ambiental
Su propio uso es pequeño. El total de la industria es la cifra seria. Aquí está la aritmética de ambos.
La IA usa energía y agua. Quien la use en las negociaciones climáticas debería poder decir cuánta. Tu propio consumo es pequeño. La demanda total es grande y sigue creciendo. Hay que decir ambas cosas. Decir solo una suele llevar a errores al tratar este tema.
13.1Tu propio consumo es pequeño
Google midió el consumo de una consulta de texto típica a Gemini: 0.24 Wh de energía, 0.03 gramos de CO2e y 0.26 mililitros de agua.11Google, Measuring the environmental impact of delivering AI at Google scale, arXiv:2508.15734, agosto de 2025. La cifra incluye la capacidad inactiva y el consumo adicional del centro de datos, que la mayoría de las estimaciones publicadas omiten. Es casi lo mismo que usar un portátil unos segundos. Incluso un día entero de uso intenso suma menos que un trayecto corto en coche.
Polly muestra esta cifra para cada cuenta y publica cómo la calcula.22El método y todas las constantes están en footprint.ts en pi-village-core. Una cifra que un negociador no puede examinar es peor que no tener ninguna. El cálculo parte de qué parte del modelo está activa para cada palabra que procesa:
Leer tu consulta consume cerca de una cuarta parte de lo que consume escribir la respuesta. Volver a leer una consulta que el sistema ya ha visto consume una décima parte. Por eso, los tres consumos se cuentan por separado. Polly usa un modelo que activa 18 mil millones de sus parámetros por cada token. Con ese modelo, un intercambio típico consume unos 0.10 Wh y 0.11 mililitros de agua. Es menos que la cifra de Google.33La constante de julios por token se calibra con la prueba ML.ENERGY, que mide directamente las GPU en 1,858 configuraciones de servicio, en vez de suponer un valor. Esto redujo la estimación a la mitad: el valor anterior subestimaba lo bien que un servidor ocupado agrupa el trabajo.
Toma todas estas cifras como aproximaciones que pueden variar por un factor de dos. No incluyen la energía para entrenar el modelo, el agua para generar la electricidad, tu propio dispositivo ni el carbono que se emite al fabricar los equipos.
13.2La demanda total es grande
Una consulta consume poco. Miles de millones, no, y cada mes más personas las envían. La demanda de electricidad de los centros de datos crece más rápido que la transición de las redes a la energía limpia. Se construyen nuevos centros de datos en lugares donde ya falta agua. Y las empresas que publican las bajas cifras por consulta han visto aumentar sus emisiones totales desde que empezaron a construir estos sistemas.
La cifra por consulta también omite el entrenamiento, que consume mucho. Antes de que un modelo avanzado responda una sola pregunta, entrenarlo consume gigavatios-hora de electricidad. Ese coste se reparte entre todas las consultas que el modelo responde a lo largo de su vida. Así, desaparece en la cifra por consulta, pero es grande a escala nacional.
Tu propio consumo es pequeño. El total al que contribuye supone una gran demanda de energía, agua y suelo que sigue creciendo. Informar de lo primero sin lo segundo es una forma de contabilidad que un negociador nunca aceptaría de otra Parte.
13.3Qué hacer al respecto
Desactiva el razonamiento cuando no lo necesites. Es lo que más reduce el consumo y solo requiere cambiar un ajuste. El mismo modelo con el razonamiento activado puede usar entre veinte y cuarenta veces más tokens, y el consumo de energía aumenta con los tokens. Traducir, resumir y cambiar el formato casi nunca requieren razonamiento.
Después, elige un modelo más pequeño. Algunos modelos solo usan unos pocos miles de millones de sus parámetros por cada token. Su coste es una fracción del de un modelo que usa todos sus parámetros. Lo que pagas en energía es la parte activa del modelo, no su tamaño anunciado.
No uses el precio como indicador de la huella. Entre los modelos abiertos que publican suficientes datos para comprobarlo, el precio y el consumo de energía sí varían juntos. Pero el precio por unidad de cómputo varía hasta sesenta veces. Dos modelos pueden costar lo mismo aunque uno consuma varias veces más energía.
Pide a los proveedores sus cifras, incluidas las de agua. Pregunta qué red eléctrica abastece tus consultas. Son preguntas razonables para un proveedor y pocas personas las hacen.
Informa de tu propio consumo cuando uses estas herramientas en tu trabajo. Una delegación que publica la huella de su propio uso de IA puede pedir con razón que otras hagan lo mismo.
Conclusión y recomendaciones
Fortalezas, debilidades y recomendaciones para negociadores y sus programas.
14.1Fortalezas y debilidades
Fortalezas. Los modelos leen y resumen rápido los grandes volúmenes de texto de los que depende la política climática. Pueden escribir informes, redactar políticas y simular negociaciones en lenguaje sencillo, lo que ahorra tiempo y dinero. Pueden ayudar a muchas personas a la vez: responsables de políticas, investigadores y activistas.
Debilidades. Los modelos pueden tener sesgos que influyen en sus respuestas si nadie los revisa y corrige. Su calidad depende de los datos con los que aprendieron, lo que limita cómo abordan los matices de los temas climáticos. Sin revisión humana, suelen interpretar mal el lenguaje jurídico y técnico complejo.
Oportunidades. Mensajes adaptados a distintos grupos que trabajan en temas climáticos. Conexiones con otras herramientas que analizan datos ambientales y ayudan a mejorar las políticas. Explicar la política climática a personas que no son expertas.
Amenazas. Desinformación, cuando un modelo produce contenido erróneo o engañoso a partir de malas fuentes. Dependencia excesiva, que impide desarrollar conocimientos locales sobre política climática. Falta de transparencia y rendición de cuentas cuando las máquinas ayudan a tomar decisiones.
Los agentes añaden dos amenazas más. Primero, las delegaciones ricas tendrán sistemas bien gestionados, mientras que las más pequeñas usarán herramientas gratuitas con condiciones poco claras. Parece que todos tienen el mismo acceso, pero la brecha crece. Segundo, cuando varias personas y herramientas trabajan en un texto, cuesta saber quién es responsable de él. Decídanlo de antemano.
14.2Recomendaciones
Vale la pena crear tres cosas: herramientas que traduzcan el lenguaje técnico de la UNFCCC, plataformas que analicen negociaciones pasadas y apoyo que dé a los jóvenes negociadores la tecnología que necesitan para participar. Conviene añadir otras seis.
Competencias digitales. Formación para aprender a usar bases de datos y sitios web sobre política internacional.
Apoyo en directo. Herramientas que expliquen las cosas durante una negociación, cuando hace falta, en vez de después.
Práctica de negociación. Simulaciones de negociaciones para practicar distintas situaciones.
Financiación. Plataformas de financiación colectiva o pequeñas subvenciones para ayudar a los negociadores a pagar su asistencia. Los negociadores de Liberia y Paraguay plantearon esta idea.
Formación intercultural. Programas sobre los malentendidos que describieron los negociadores de Perú y Nigeria.
Mentoría. Redes que conecten a jóvenes negociadores con otros con experiencia, para transmitir conocimientos entre ciclos.
Para un negociador, cuatro hábitos cubren lo esencial. Usa estos sistemas para prepararte, como apoyo lingüístico y para recordar. Verifica todo lo que vayas a decir en voz alta. Nunca dejes que un sistema hable en nombre de tu Parte. Sigue investigando lo suficiente por tu cuenta para poder hacerlo sin ayuda.
Para una delegación, deja por escrito qué herramientas se pueden usar, qué se puede pegar en ellas y quién aprueba un texto escrito con ayuda de la IA. Basta una página, y cuesta menos que una filtración.
Puedes enviar preguntas y comentarios a team@gainforest.net.
Referencias
Numeradas como las citan las notas al margen.
- El perceptrón de Rosenblatt y la demostración de 1958, Cornell Chronicle
- Krizhevsky, Sutskever, Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS 2012
- Vaswani et al., Attention Is All You Need, Google Research 2017
- Radford et al., Language Models are Unsupervised Multitask Learners, OpenAI 2019
- Kaplan et al., Scaling Laws for Neural Language Models, OpenAI 2020
- Hoffmann et al., Training Compute-Optimal Large Language Models, NeurIPS 2022
- OpenAI, Introducing ChatGPT, 30 de noviembre de 2022
- OpenAI, Learning to Reason with LLMs, 12 de septiembre de 2024
- DeepSeek, DeepSeek-R1, 20 de enero de 2025
- METR, Measuring AI Ability to Complete Long Tasks, 2025
- Anthropic, Anthropic Economic Index, 2025, uso por país y nivel de ingresos
- Global Biodiversity Information Facility, datos de presencia y su sesgo geográfico de muestreo, gbif.org y el blog de datos de GBIF
- Artificial Analysis, Intelligence Index by Open Weights and Proprietary, 26 de agosto de 2026
- Artificial Analysis, Intelligence Index vs. Cost per Intelligence Index Task, 26 de agosto de 2026
- NVIDIA, DGX Spark user guide and hardware overview
- The Computational Democracy Project, Polis, compdemocracy.org/polis y el código fuente
- The Computational Democracy Project, vTaiwan, estudio de caso, desde 2014
- AI Objectives Institute, Talk to the City, talktothe.city y ai.objectives.institute
- Team Mirai, kouchou-ai (広聴AI), escucha amplia para municipios japoneses, GitHub
- Team Mirai, AI interviews and the digital democracy manifesto, policy.team-mir.ai; Bruce Schneier y Nathan Sanders, Japan's Team Mirai Uses Tech to Bolster Democracy, Not Undermine It, Tech Policy Press, marzo de 2026
- Agora Citizen Network, agoracitizen.network y From ZK-first to AT Protocol, our path to DDS, blog
- Low, Duys, Formanek, Hammond, Bakker, Habermolt: Delegating Deliberation to AI Representatives, arXiv:2605.24413
- Tessler et al., AI can help humans find common ground in democratic deliberation (la Habermas Machine), Science, 2024
- GainForest, Simocracy, un registro público de agentes de IA creados por ciudadanos en AT Protocol, simocracy.org
- Foresight Institute y Cooperative AI Foundation, Supercooperation: The Future of AI for Democracy, notas del taller, taller paralelo de ICML, Seúl, julio de 2026
- Anthropic, What 81,000 people told us about AI, entrevistas moderadas por IA a gran escala
- Google, Measuring the environmental impact of delivering AI at Google scale, arXiv:2508.15734, agosto de 2025
- Epoch AI, How much energy does ChatGPT use?, 2025
- GainForest,
footprint.tsen pi-village-core, el cálculo de las cifras por cuenta de Polly - GainForest, Generative AI + Climate Guide 2024, preparado para Climate Youth Negotiator Programme antes de COP29
Quién hizo esto
Esta guía viene de GainForest y de la Youth Negotiators Academy, escrita para el Climate Youth Negotiator Programme.
Nada de lo que escriba en este sitio sale de su navegador, y la búsqueda funciona en local.
La actualizamos a medida que cambian las herramientas. Si algo está mal, desactualizado o falta, díganoslo. Si quiere ejecutar su propia IA soberana, formar a su delegación o trabajar con nosotros en la próxima edición, escriba a team@gainforest.net.
Con el apoyo de Robert Bosch Foundation y Protocol Labs.
team@gainforest.net