Introduction
Pourquoi les négociateurs se tournent vers ces outils, ce qu'ils font bien, et comment lire ce livre.
Les négociations climatiques reposent sur des documents. Il y en a des milliers, rédigés dans un vocabulaire particulier qui change d’une session à l’autre. Les mots exacts d’un texte peuvent décider du résultat. Les modèles de langage d’IA peuvent vous aider à lire, à écrire et à vous préparer plus vite.
1.1Pourquoi s’y intéresser ?
Les jeunes négociateurs aux négociations climatiques de l’ONU (la UNFCCC) parlent au nom de la génération qui vivra avec les décisions d’aujourd’hui. Beaucoup rencontrent les mêmes problèmes. Il y a trop à lire. Le langage politique est difficile à suivre. Et il y a peu de temps pour faire passer une idée.
Les modèles de langage peuvent aider dans chacun de ces cas. Un modèle de langage est un programme informatique entraîné sur une très grande quantité de textes. Il peut lire, résumer et rédiger des textes sur demande. Pour les négociateurs, il est utile de quatre façons.
Comprendre l’information. Transformer de longs rapports et des données en résumés courts, pour suivre les nouvelles découvertes.
Rédiger. Vous aider à formuler une idée dans le langage admis dans les négociations, assez clairement pour qu’elle soit remarquée.
Travailler dans plusieurs langues. Traduire des textes et expliquer leur contexte, pour que davantage de personnes puissent participer sur un pied d’égalité.
S’entraîner. Jouer le rôle de l’autre partie dans une négociation simulée, pour vous exercer avant la vraie.
L’outil ne fait pas tout. Les négociateurs qui apprennent à bien l’utiliser ont plus de temps pour le travail qui demande une présence humaine.
1.2Comment utiliser ce guide
La première moitié explique ce que sont ces systèmes, ce dont les négociateurs ont besoin et comment demander à un modèle quelque chose d’utile. La seconde moitié porte sur les agents. Un agent est un modèle qui peut lire tout un ensemble de documents et accomplir une tâche en plusieurs étapes. Les derniers chapitres expliquent qui contrôle vos données, comment faire fonctionner un modèle vous-même et ce que l’IA coûte à l’environnement. Chaque chapitre propose des instructions à copier. Vous n’avez pas besoin de connaissances techniques.11La première édition a été rédigée en 2024 pour le Climate Youth Negotiator Programme. Les entretiens du chapitre 3 et de l’annexe proviennent de ce travail.
Que sont les grands modèles de langage ?
Du perceptron à l'assistant dans votre navigateur. Ce que sont ces systèmes et d'où ils viennent.
2.1Comment nous en sommes arrivés là
En 1957, le psychologue Frank Rosenblatt a commencé à travailler sur le perceptron au Cornell Aeronautical Laboratory. La marine américaine en a présenté une version fonctionnelle l’année suivante. Un perceptron est un modèle mathématique très simple d’une cellule du cerveau. Il reçoit plusieurs entrées, donne un poids à chacune et produit une sortie. Il ne copiait pas un vrai cerveau, mais les systèmes d’IA actuels en sont en partie issus.
Puis les progrès ont stagné pendant des décennies. Les données manquaient, les ordinateurs étaient trop lents et les méthodes d’entraînement peu efficaces. Les choses ont repris quand ces trois éléments se sont améliorés en même temps. En 2012, Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton ont entraîné un système appelé AlexNet sur 1,2 million d’images étiquetées, avec des puces graphiques conçues pour les jeux vidéo. La bonne réponse figurait parmi ses cinq premiers choix pour toutes les images de test sauf 17 pour cent, un résultat bien meilleur qu’avant.11Ce résultat venait autant de la conception, des astuces d’entraînement et du jeu de données que du matériel.
En 2017, des chercheurs de Google ont présenté le Transformer. Un Transformer examine tous les mots d’un passage à la fois et détermine lesquels comptent les uns pour les autres. Il peut ainsi relier des idées éloignées dans un texte. Les Transformers s’entraînent aussi vite sur de nombreuses puces à la fois. Presque tous les systèmes de ce guide reposent sur cette architecture.
OpenAI a ensuite entraîné des Transformers à une tâche simple : prédire le mot suivant. Ses premiers modèles, GPT et GPT-2, ont montré que cette seule tâche apprenait plusieurs compétences à la fois à un modèle. Il n’était plus nécessaire d’avoir un système distinct pour chaque tâche. Les chercheurs ont aussi découvert des lois d’échelle. Les modèles s’amélioraient de façon prévisible avec plus de puissance de calcul, plus de données et une plus grande taille, tant que ces trois éléments augmentaient ensemble.
Le 30 novembre 2022, OpenAI a lancé ChatGPT en accès gratuit à titre d’essai pour la recherche. Pour la première fois, tout le monde pouvait discuter avec l’un de ces modèles.
Deux autres changements ont suivi. En septembre 2024, OpenAI a annoncé o1, et en janvier 2025, DeepSeek a lancé R1. Tous deux font un effort supplémentaire avant de répondre. Ils rédigent d’abord des notes de travail plus longues, ce qui aide à résoudre les problèmes en plusieurs étapes. Les modèles ont aussi été reliés à des outils et autorisés à agir en boucle. Le chapitre 6 en parle.
2.2La recette
Un modèle de langage est un type d’IA qui lit et écrit en langage humain. Il apprend à partir d’énormes quantités de textes : livres, articles, sites web, etc. Il y apprend des régularités et s’en sert pour écrire de nouveaux textes.
ChatGPT, Llama de Meta et les modèles similaires sont construits en deux étapes. D’abord le préentraînement. Puis le post-entraînement, qui comprend désormais deux parties. La seconde permet aux modèles récents de résoudre des problèmes longs.
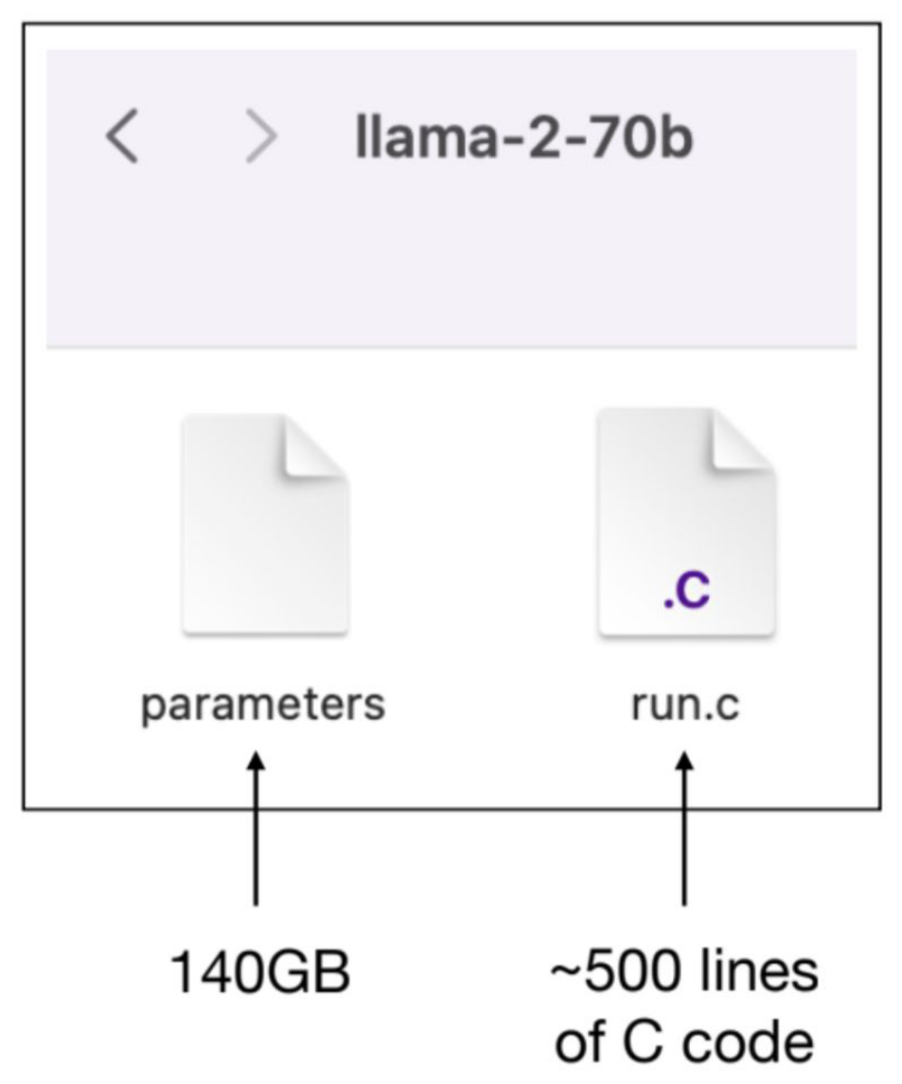
Préentraînement. Le modèle lit une immense quantité de textes sur internet et s’exerce à prédire le mot suivant. Il ne garde pas de liste de ses lectures. Au passage, il acquiert la grammaire, des faits sur le monde et une certaine capacité à raisonner. Il apprend ainsi une quantité surprenante de choses, des petits faits du quotidien aux idées complexes.
Ajustement supervisé. La première partie du post-entraînement. Des personnes rédigent et évaluent des exemples de réponses selon des consignes écrites. Le modèle s’entraîne sur ces exemples et apprend à appliquer les mêmes critères aux nouvelles demandes. Cette étape lui apprend à suivre une consigne au lieu de simplement poursuivre votre phrase.
Apprentissage par renforcement. La seconde partie, plus récente. On ne montre pas au modèle de bonne réponse à copier. Il reçoit une récompense quand il arrive à un bon résultat. Avec le temps, il apprend quelles façons de résoudre un problème fonctionnent. C’est ce qui lui permet de suivre un long enchaînement d’étapes avant de répondre.
2.3Limites
Les chercheurs ne comprennent pas encore tout le fonctionnement interne de ces modèles. Selon l’idée la plus répandue, le préentraînement donne au modèle ses connaissances, et le post-entraînement façonne leur utilisation.
Une chose est claire. Un modèle de langage choisit le mot suivant selon les régularités des textes de son entraînement. Cela fonctionne bien pour beaucoup de tâches, mais pose deux grands problèmes. Le modèle reproduit les biais des textes dont il a appris. Et il affirme des choses fausses avec une totale assurance. C’est ce qu’on appelle une hallucination. Une phrase qui sonne juste n’a pas été vérifiée.
2.4D’où viennent les biais
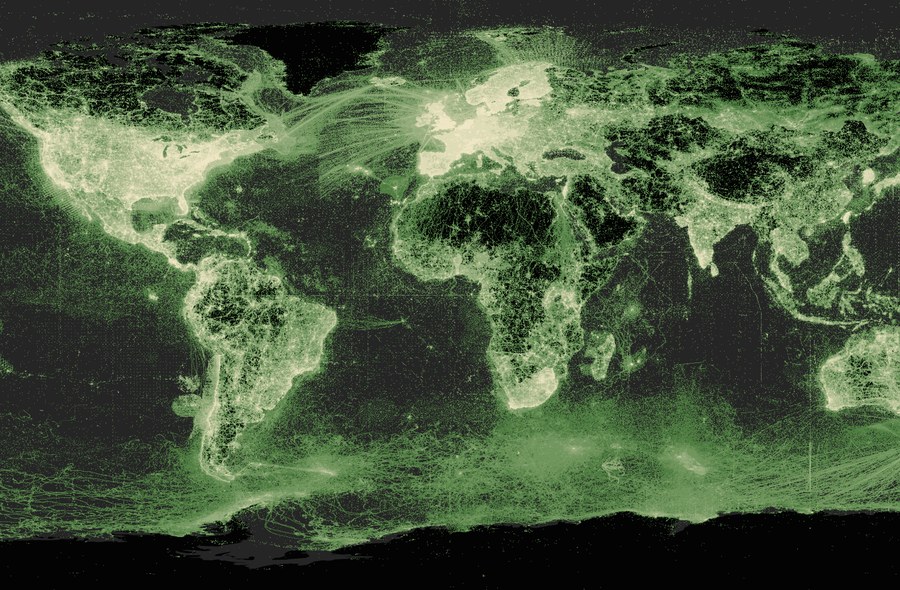
Ces modèles apprennent sur internet, qui ne couvre pas le monde de façon égale. Pour les négociateurs sur le climat, cela compte beaucoup.
Prenons les données sur la nature. Le Global Biodiversity Information Facility (GBIF) est la plus grande base de données ouverte au monde sur les observations d’espèces. Environ 83 pour cent de ses données viennent d’Amérique du Nord et d’Europe. Les 17 pour cent restants couvrent le reste du monde, y compris les endroits qui comptent le plus d’espèces.
Les textes présentent le même déséquilibre. Il y a bien plus de textes en ligne en anglais, en français et en espagnol qu’en quechua, en twi ou en tok pisin. Un modèle a donc vu beaucoup plus de textes du premier groupe. Il traduira, résumera et rédigera bien dans une langue courante. Dans une langue moins courante, il fera plus d’erreurs, avec autant d’assurance.
C’est aussi une cause majeure d’hallucination. Posez une question sur un lieu bien documenté et le modèle s’appuie sur beaucoup de contenu. Pour un lieu peu documenté, il a bien moins d’éléments et comble les lacunes par des suppositions. Sa réponse paraît tout aussi sûre. Elle risque simplement davantage d’être fausse.
On ne peut pas en attribuer simplement la faute à quelqu’un. Recueillir et publier des données coûte de l’argent et demande des systèmes dont beaucoup de pays manquent. Certaines communautés choisissent de ne pas partager leurs savoirs sur leurs terres et leurs espèces, et c’est leur droit. Mais le résultat est le même. Ces outils fonctionnent le mieux pour les lieux qui ont déjà beaucoup de données, et le moins bien pour ceux qui ont le plus à perdre.
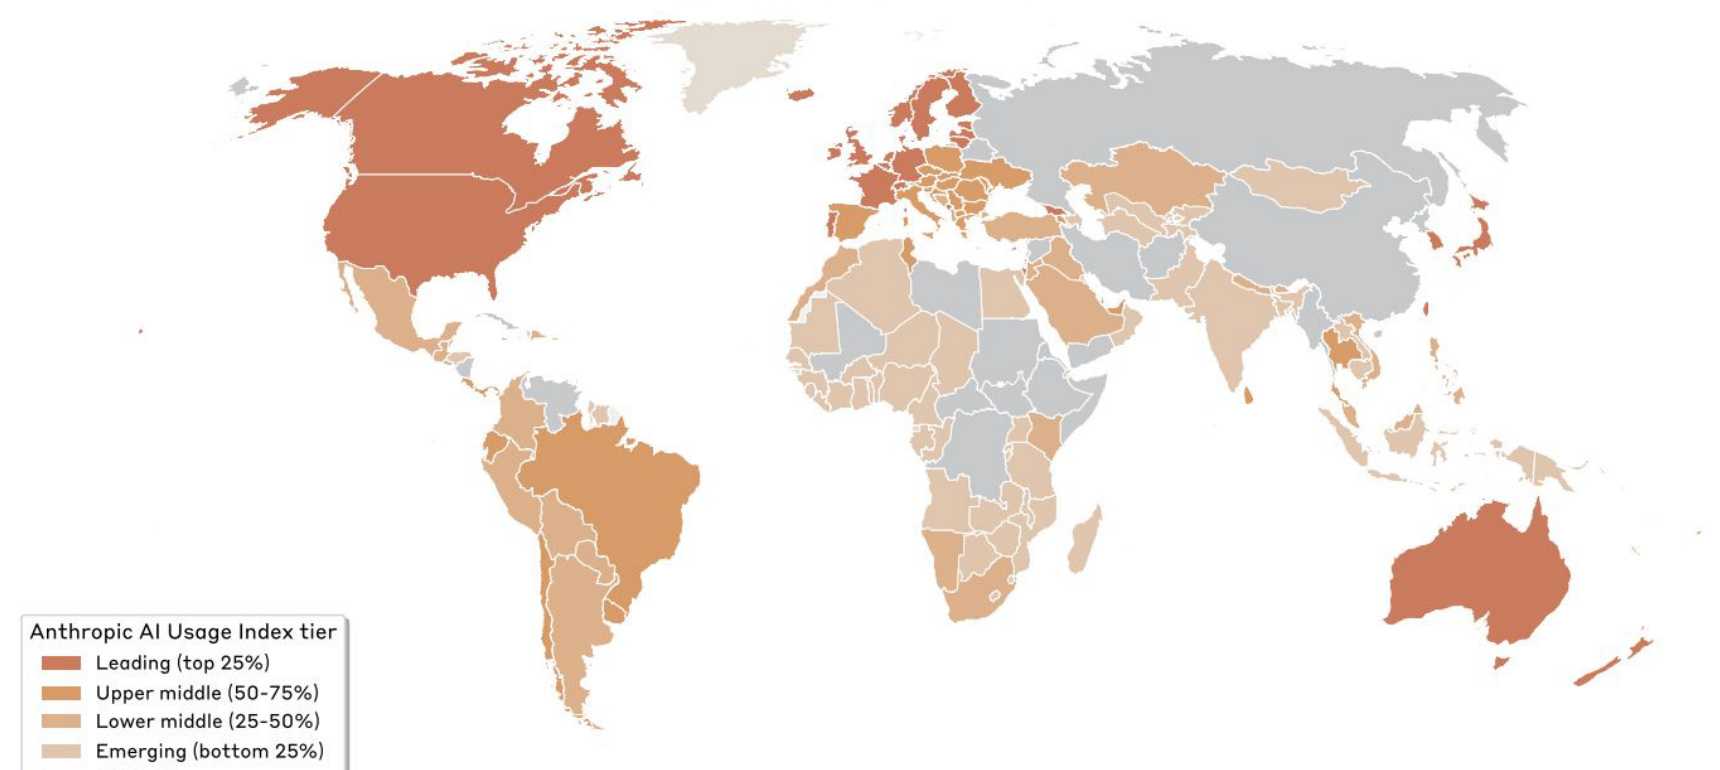
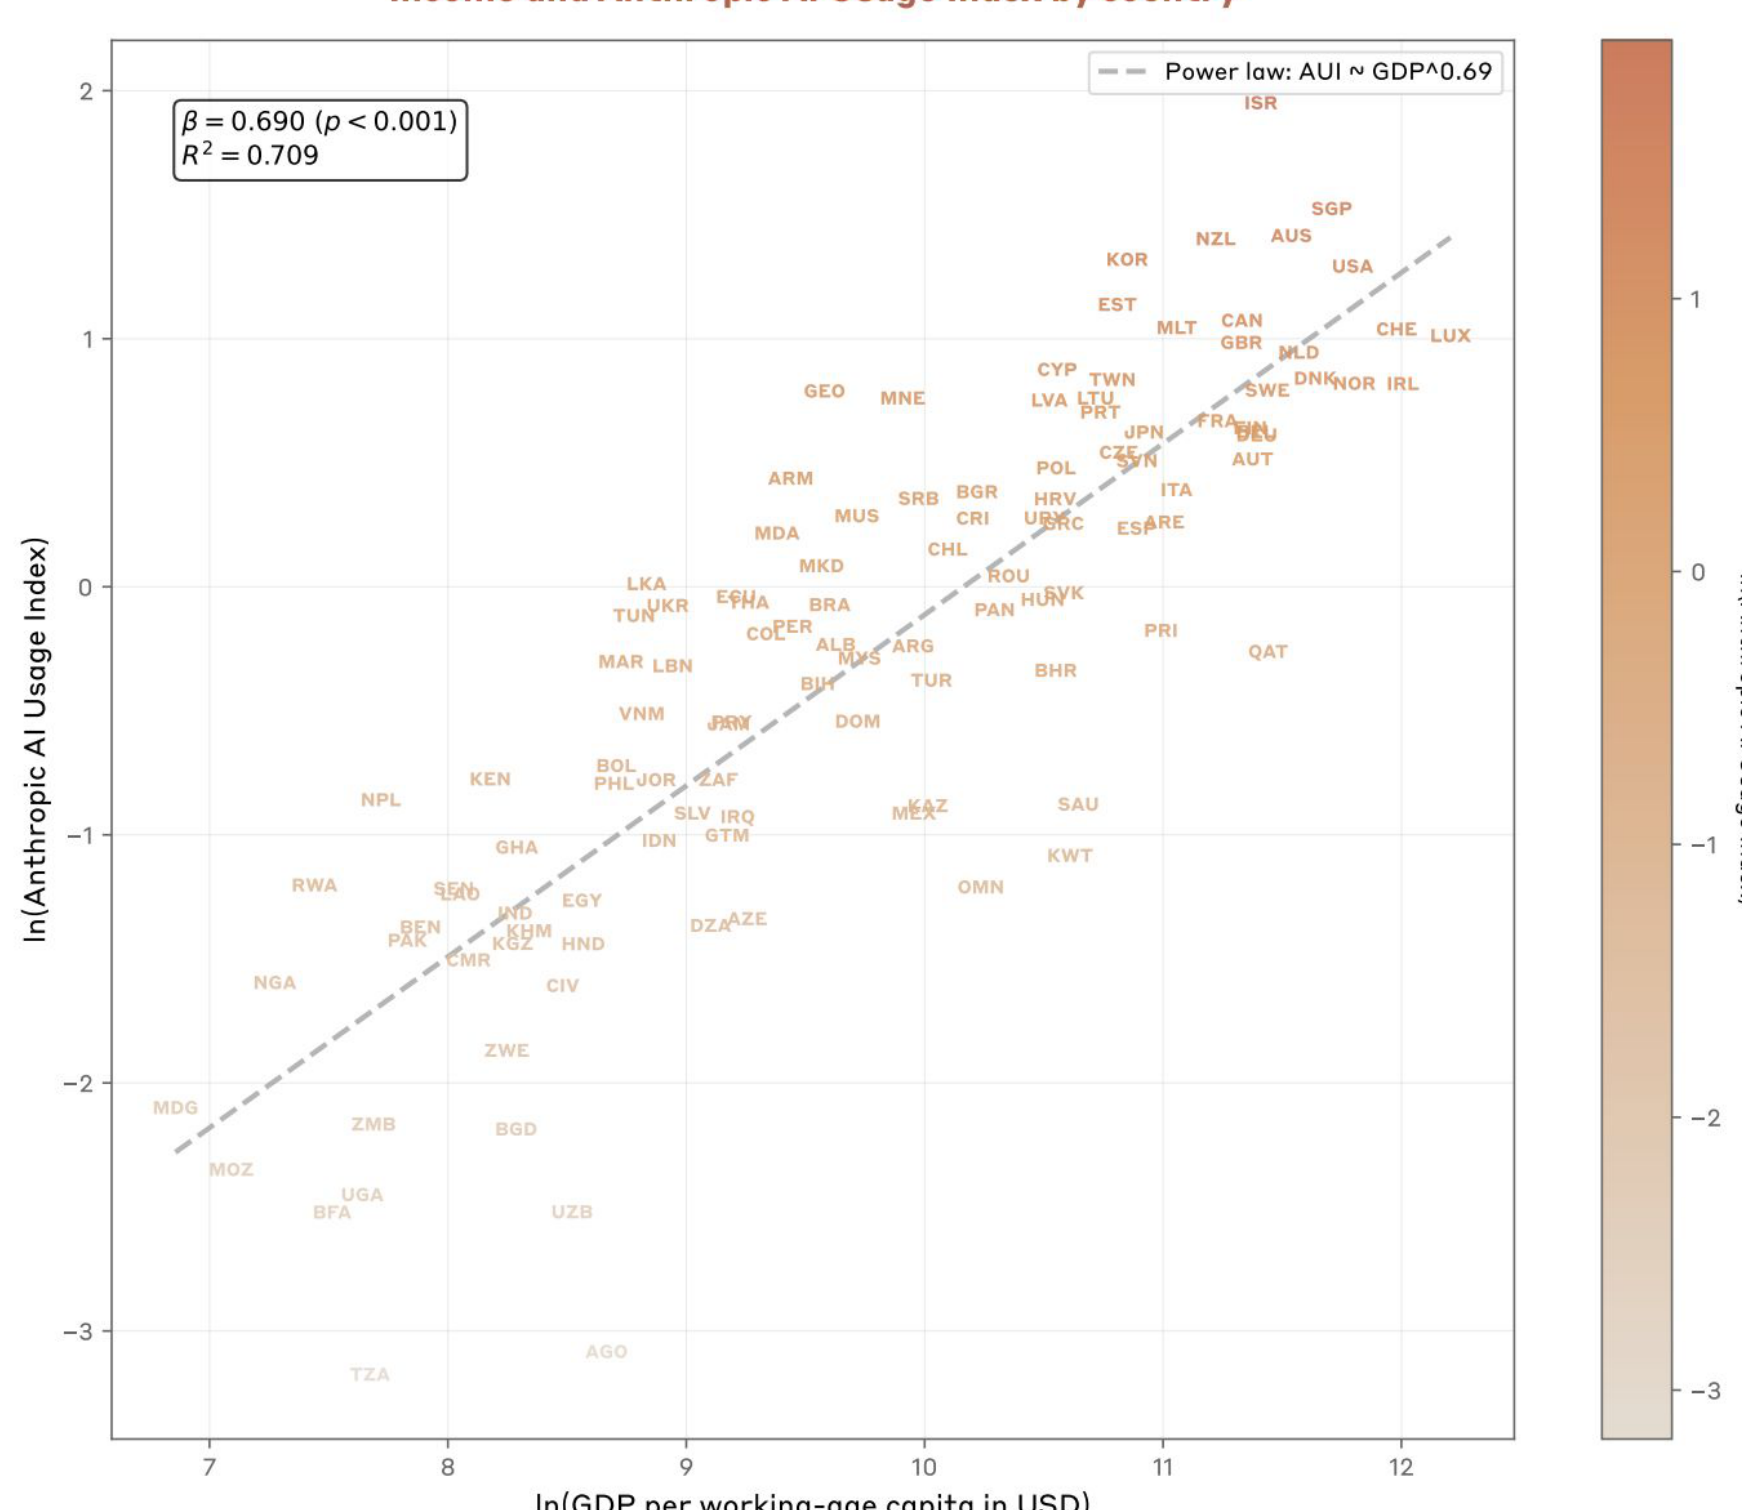
Le même écart se retrouve dans l’utilisation de ces outils. Anthropic publie un indice d’utilisation de Claude par pays. L’utilisation augmente fortement avec le revenu national, et vingt-cinq pays ne l’utilisent presque pas.22Anthropic, Anthropic Economic Index, 2025. L’utilisation croît à peu près comme le PIB par personne en âge de travailler élevé à la puissance 0,69. Parmi eux figurent les Tonga, les Samoa, Nauru et les Palaos. Ces pays participent aux mêmes négociations et comptent parmi les plus exposés aux changements climatiques.
Points de vue des parties prenantes
De jeunes négociateurs disent ce qui rend le travail difficile. Leurs réponses fixent la barre pour chaque outil de ce livre.
Nous avons interrogé de jeunes négociateurs climatiques de plusieurs pays. Ils ont décrit les mêmes problèmes et souhaitaient des formes d’aide similaires.11Six négociateurs du Libéria, du Paraguay, du Pérou, du Nigéria, du Liban et de l’Indonésie. Le résumé complet figure en annexe.
3.1Principales difficultés
Langue. La plupart des personnes dans la salle n’ont pas l’anglais comme langue maternelle.
Termes techniques. Il faut des années pour apprendre le jargon de l’UNFCCC (Libéria, Paraguay).
Transmission des connaissances. Certaines personnes ont les connaissances techniques, d’autres non. Une grande partie se perd quand les délégués changent entre les sessions.
Historique. Il est difficile de savoir ce qui s’est passé lors des négociations précédentes (Liban).
Échanges avec les négociateurs expérimentés. Ces échanges sont difficiles sous pression (Pérou, Nigéria). Les jeunes délégués doivent gagner le respect des autres pour se faire entendre.
Comprendre les autres Parties. Les positions changent vite et sont difficiles à suivre.
Temps. Le temps manque toujours pour assimiler tout ce qui compte.
S’exprimer clairement. Exprimer vite et avec précision une idée complexe en anglais reste un défi constant.
3.2Outils et ressources souhaités
Outils linguistiques. Une meilleure aide à la rédaction et à la grammaire, adaptée aux textes de l’UNFCCC plutôt qu’à l’anglais des affaires.
Recherche rapide. Des outils qui parcourent de longs documents, en extraient les passages importants et confirment quelle version d’un texte est la plus récente.
Formation adaptée. Des supports adaptés à la région, au groupe de négociation et à l’expérience de chaque négociateur.
Au moment des entretiens, les négociateurs utilisaient Grammarly pour rédiger et Google Drive pour travailler ensemble. L’un d’eux n’utilisait aucun outil de traduction, car le sens des termes de négociation se perd dans la traduction.
Les grands modèles de langage pour les négociations
Où un modèle de langage aide dans le cycle de négociation, et où il n'aide pas.
Les négociations climatiques couvrent de nombreux sujets à la fois : émissions, biodiversité, argent et politique. Pour suivre, il faut trois choses à un négociateur.
Un accès rapide à l’information. La science du climat évolue sans cesse, et les négociateurs ont vite besoin des données les plus récentes.
Une rédaction soignée. Un seul mot peut faire réussir ou échouer un accord.
Plusieurs langues. Les Parties viennent du monde entier et parlent de nombreuses langues.
4.1Là où les modèles sont utiles
Communication. Rédiger et traduire des textes pour que les Parties de langues maternelles différentes se comprennent bien.
Recherche. Rassembler et résumer de nombreux documents, comme des études scientifiques, des documents d’orientation et des accords passés, pour rester à jour.
Explorer des scénarios. Discuter des effets possibles de différents choix politiques pour tester une position avant de s’y engager.11On parle parfois de modélisation prédictive, mais c’est exagéré. Les modèles de langage ne font pas tourner de modèles climatiques ou économiques. Ils reformulent et comparent des scénarios. Tout chiffre qu’ils produisent doit être vérifié auprès d’une source réelle.
Résumer les arguments. Présenter les arguments de chaque Partie pour repérer les points clés et les contre-arguments.
4.2Les pièges possibles
Les avantages sont réels. Les risques aussi, et certains comptent beaucoup en diplomatie.
Trop simplifier. Les modèles raccourcissent les textes. Ce faisant, ils peuvent supprimer la seule nuance qu’une Partie a défendue pendant trois sessions.
Ne pas sentir l’ambiance. Un modèle ne peut pas saisir l’ambiance ni les enjeux politiques d’une négociation. Il ne sait pas ce qui a été convenu dans les couloirs.
Aucune expertise réelle. Un modèle peut sembler expert en politique climatique sans l’être. Si vous vous fiez à lui, vous risquez d’obtenir des informations incomplètes ou fausses.
Sécurité et confidentialité. Les négociations portent souvent sur des informations sensibles. Tout ce que vous collez dans un service d’IA en ligne quitte votre délégation. Peu de gens lisent les conditions qui précisent comment ces données sont stockées.
Éthique. Dites quand vous utilisez l’IA. Gardez la responsabilité des décisions entre les mains des personnes. Surveillez les usages abusifs.
Malentendus. Un modèle peut mal comprendre votre demande. Il peut vous donner un texte qui semble refléter votre position, mais qui ne la reflète pas.
Utiliser les modèles
Quel modèle et à quelles conditions, comment écrire une consigne, et une bibliothèque à copier.
5.1Quel modèle, et à quelles conditions
Il existe deux types d'assistants IA. Le type choisi compte plus que la marque.
Poids fermés. ChatGPT, Claude et Gemini fonctionnent sur les ordinateurs des entreprises. Vous y accédez avec un compte. Ce sont les modèles les plus puissants et les plus faciles à utiliser au départ. Les versions gratuites peuvent rédiger, traduire et résumer. Les versions payantes coûtent environ vingt dollars par mois. Elles acceptent des documents plus longs et des fichiers importés, et incluent les fonctions d'agent du chapitre 6. Tout ce que vous saisissez est envoyé à l'entreprise. Selon vos réglages, elle peut le conserver, le faire lire par son personnel ou s'en servir pour entraîner son prochain modèle.
Poids ouverts. Llama, Mistral, Qwen, Gemma et DeepSeek publient leurs modèles pour que chacun puisse les télécharger. Vous, votre institution ou un prestataire de votre choix pouvez donc les faire fonctionner. Ollama en installe un sur un ordinateur portable en quelques minutes. Polly, géré par GainForest et la Youth Negotiators Academy sur polly.ai4cop.org, est un modèle à poids ouverts en ligne qui ne garde aucune trace de vos envois. Le chapitre 11 explique comment faire fonctionner le vôtre.
Une règle simple pour commencer. Utilisez un modèle fermé pour les contenus déjà publics. Utilisez un modèle à poids ouverts pour le reste. Ne collez jamais une position que votre délégation n'a pas encore présentée dans un service que vous ne contrôlez pas. Le chapitre 10 explique les enjeux. Lisez-le avant d'ouvrir un compte.
Quel que soit votre choix, installez l'application sur votre téléphone. La saisie vocale aide quand vous marchez entre deux séances. Exprimer une idée encore vague dans votre langue donne souvent un meilleur brouillon que de taper une phrase soignée en anglais.
5.2Les bases du prompt
L'instruction que vous tapez s'appelle un prompt. Plus votre prompt est clair et précis, meilleure est la réponse.
Un prompt peut avoir jusqu'à quatre parties. Elles ne sont pas toujours toutes nécessaires.
Instruction. Ce que vous voulez que le modèle fasse.
Contexte. Les informations qui aident le modèle à mieux répondre.
Données d'entrée. Le texte, la question ou le document sur lequel il doit travailler.
Format de sortie. La forme que doit prendre la réponse.
5.3Ce qui fait un bon prompt
Six habitudes font l'essentiel du travail. Elles s'appliquent à tous les modèles.
Soyez clair et précis. Dites qui vous êtes, ce que vous voulez et la forme attendue de la réponse. Le modèle ne sait pas où vous êtes ni ce qui se passe autour de vous.
Montrez un exemple. Un exemple de la réponse voulue fonctionne mieux qu'un paragraphe qui la décrit.
Demandez des citations. Dites au modèle de citer le passage sur lequel il s'appuie. Relier une réponse à un vrai document est la meilleure protection contre les faits inventés.
Nommez les parties. Placez chaque partie dans des balises, comme <contexte>, <tâche> et <texte>. Le modèle peut alors distinguer votre instruction du document collé.
Laissez-le d'abord réfléchir. Demandez le raisonnement avant la réponse. Les modèles font moins d'erreurs dans les tâches à plusieurs étapes quand ils les suivent une à une.
Donnez-lui un rôle. « Vous faites de la recherche sur les pertes et préjudices » donne généralement une meilleure réponse que la même demande sans rôle.
Puis continuez. Améliorez le prompt et recommencez. Le deuxième essai est presque toujours meilleur que le premier.
Prenez une habitude dès le départ. Demandez des sources et demandez au modèle de signaler les points dont il n'est pas sûr. Si vous ne pouvez pas vérifier une réponse, vous ne pouvez pas l'utiliser en séance plénière.
Les éléments d'une intervention
Les négociateurs rédigent surtout des interventions. Un bon prompt pour une intervention a cinq parties : qui parle et où, le sujet précis, les faits, l'accord concerné et l'action à mener.
1En tant que jeune délégué de Malaisie à la COP29, rédigez une intervention de deux minutes 2sur les pertes et préjudices qui touchent les enfants en Malaisie. Soulignez 3des problèmes comme la montée des eaux qui menace les communautés côtières, les perturbations scolaires dues aux effets du changement climatique et les problèmes de santé mentale des enfants. 4Proposez des recommandations précises pour financer en priorité la protection des droits des enfants et renforcer leur participation aux discussions sur le climat 5dans le cadre de l'Accord de Paris.
Omettez une partie et le brouillon sera moins bon. Sans le rôle, le modèle n'écrit pour personne. Sans les faits, il exprime des sentiments. Sans la dernière ligne, il ne fait le lien avec aucun accord permettant d'agir.
5.4Des prompts pour différents usages
- Analyse de données
À partir de ce tableur, tracez la hausse moyenne des émissions au cours des dernières années, précisez votre méthode et listez vos hypothèses sur les données manquantes.
Configuration: Import de fichier - Traduction
Traduisez ce paragraphe en espagnol, en gardant le registre formel des textes de décision.
Configuration: Tout modèle - Résumé
Résumez l'intervention du groupe des PMA au dialogue technique du bilan mondial du 10 juin 2023 et citez les passages sur lesquels vous vous appuyez.
Configuration: Recherche web activée - Préparation d'un discours
Vous rédigez les discours d'un négociateur sur le climat à l'ONU. Vous écrivez sur les efforts du Royaume-Uni en matière de renforcement des capacités. Je suis le négociateur. Quelles cinq questions me poseriez-vous pour obtenir les informations nécessaires à la rédaction d'une déclaration ?
Configuration: Tout modèle - Préparation de contre-arguments
Les pertes et préjudices sont un enjeu clé des négociations sur le climat. Vous faites de la recherche sur les pertes et préjudices. Listez les principales raisons pour lesquelles certains pays leur accordent peu de priorité. Puis rédigez un contre-argument solide montrant pourquoi un fonds pour les pertes et préjudices est nécessaire.
Configuration: Tout modèle - Rédaction d'une déclaration ou d'un discours
Vous rédigez une déclaration à partir des questions ci-dessus. Écrivez une déclaration de 300 mots sur les efforts du Royaume-Uni en matière de renforcement des capacités climatiques, dans le style du gouvernement britannique.
Configuration: Tout modèle - Explication du jargon
Expliquez en termes simples ce que signifie « moyens de mise en œuvre » dans ce paragraphe et donnez un exemple d'emploi de cette expression dans une décision antérieure.
Configuration: Tout modèle - Recherche du document
Quel texte de décision contient le mandat de ce programme de travail ? Donnez-moi la cote du document et citez le paragraphe qui le contient.
Configuration: Recherche documentaire - Traduction pour un public local
Traduisez cette intervention en malais pour un public local, en gardant le sens et en supprimant le jargon de l'UNFCCC.
Configuration: Tout modèle
Agents
Une autre façon de travailler : un mandat plutôt qu'une consigne, et dix cas d'usage à essayer.
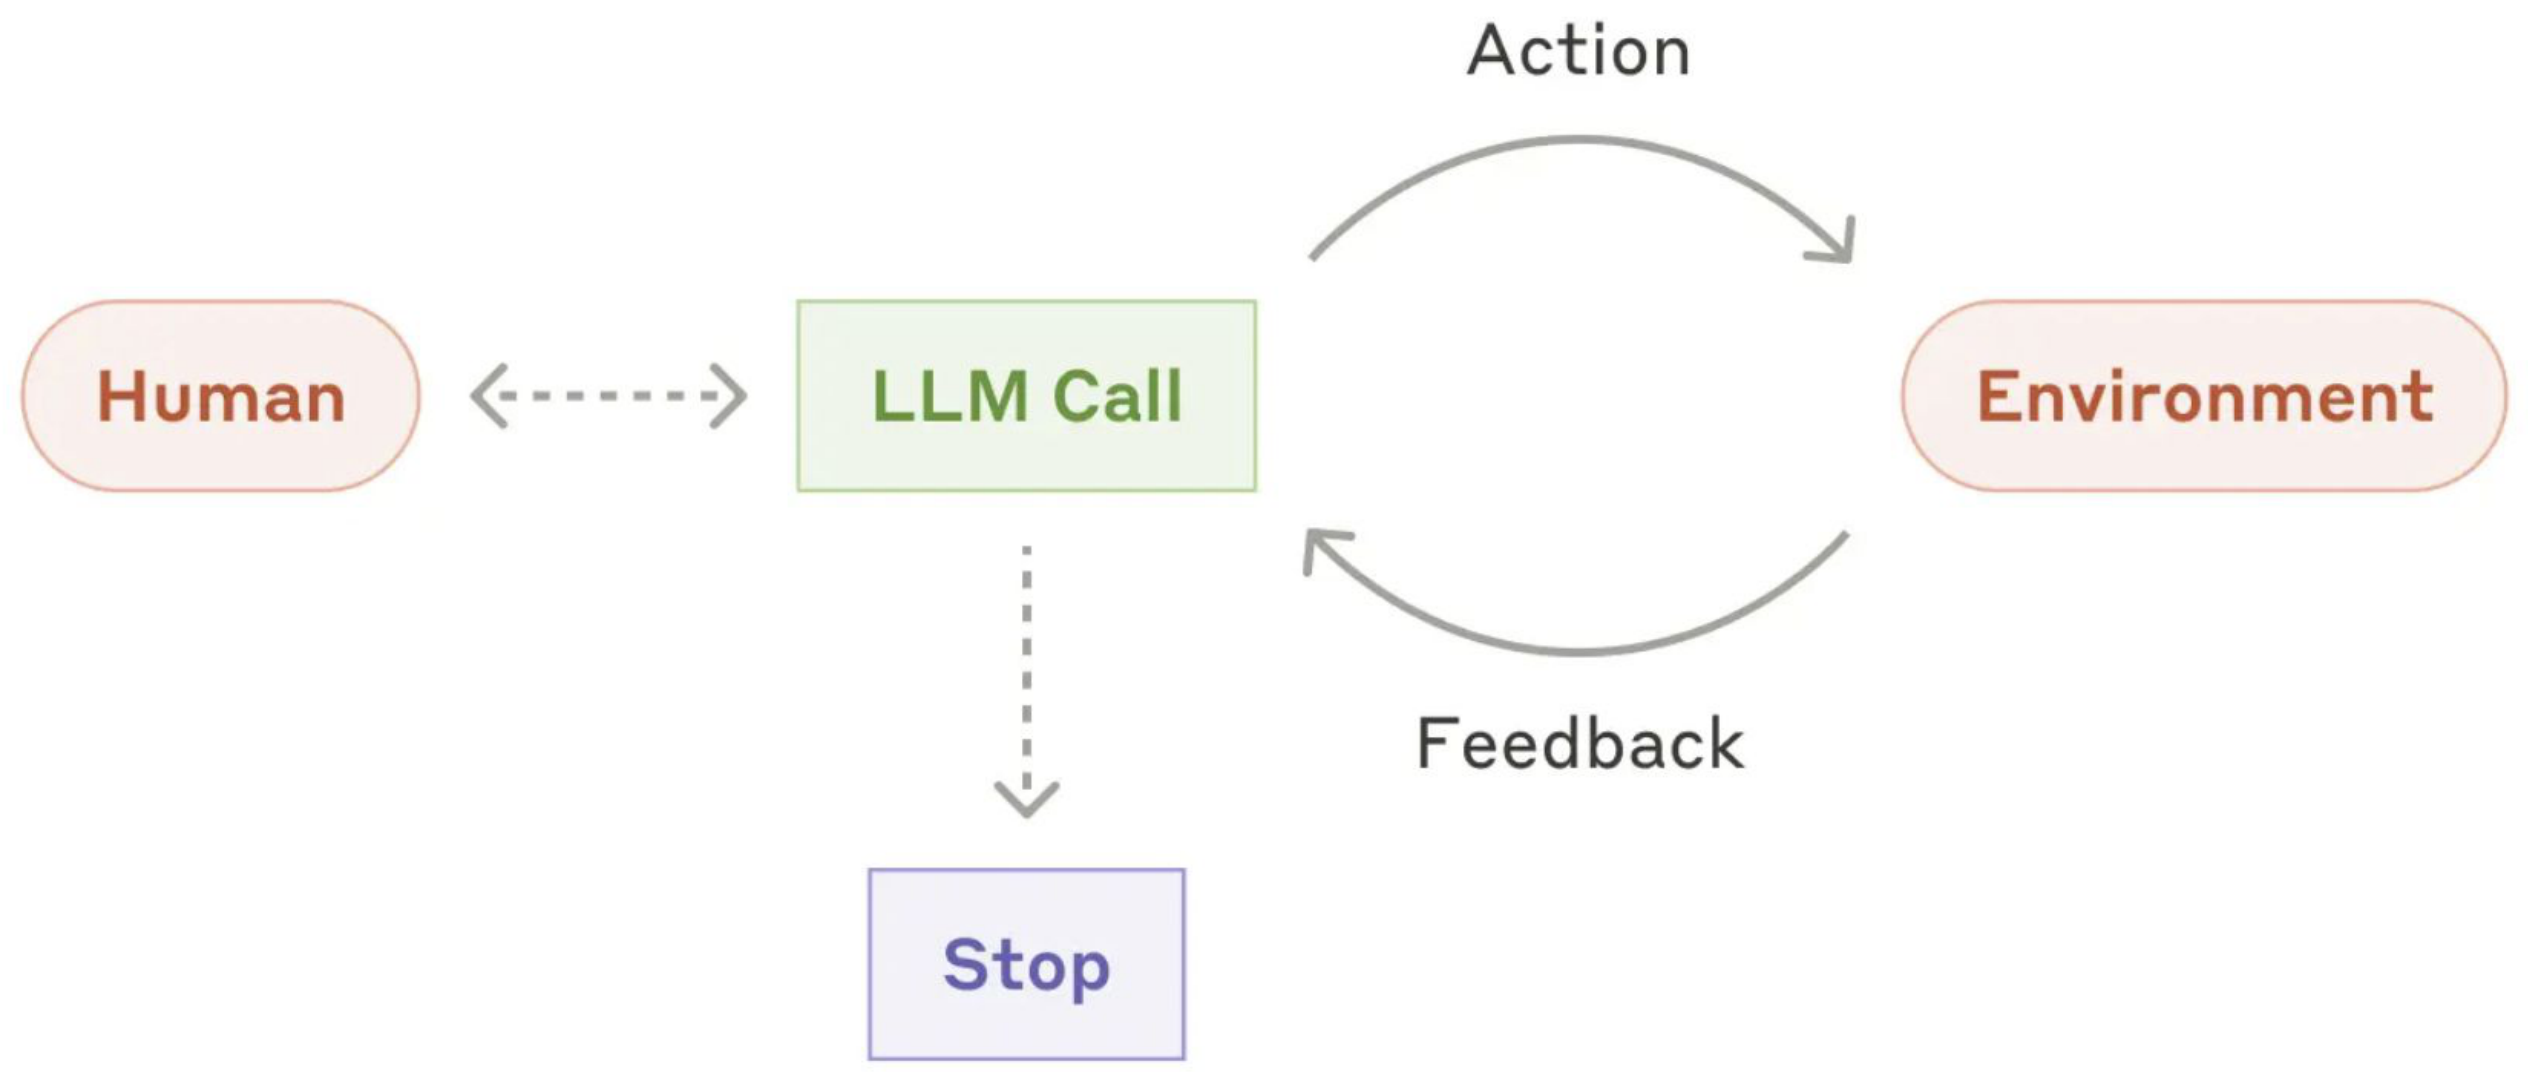
Jusqu’ici, tout fonctionnait de la même façon. Vous tapez une demande, vous lisez la réponse et vous décidez quoi en faire. Quatre changements ont ajouté une autre façon de travailler.
Les modèles peuvent lire davantage. Un modèle peut désormais lire en même temps un texte de négociation entier, ses versions précédentes et vos notes de synthèse.
Les modèles peuvent chercher. Un système peut chercher dans un ensemble de documents ou sur le web avant de répondre, et citer ce qu’il a trouvé. Vous pouvez ainsi vérifier la réponse.
Les modèles peuvent utiliser des outils. Un modèle peut être connecté à un moteur de recherche, un tableur, un calendrier ou un dossier de fichiers. Il peut alors agir sur ces éléments au lieu de seulement les décrire.
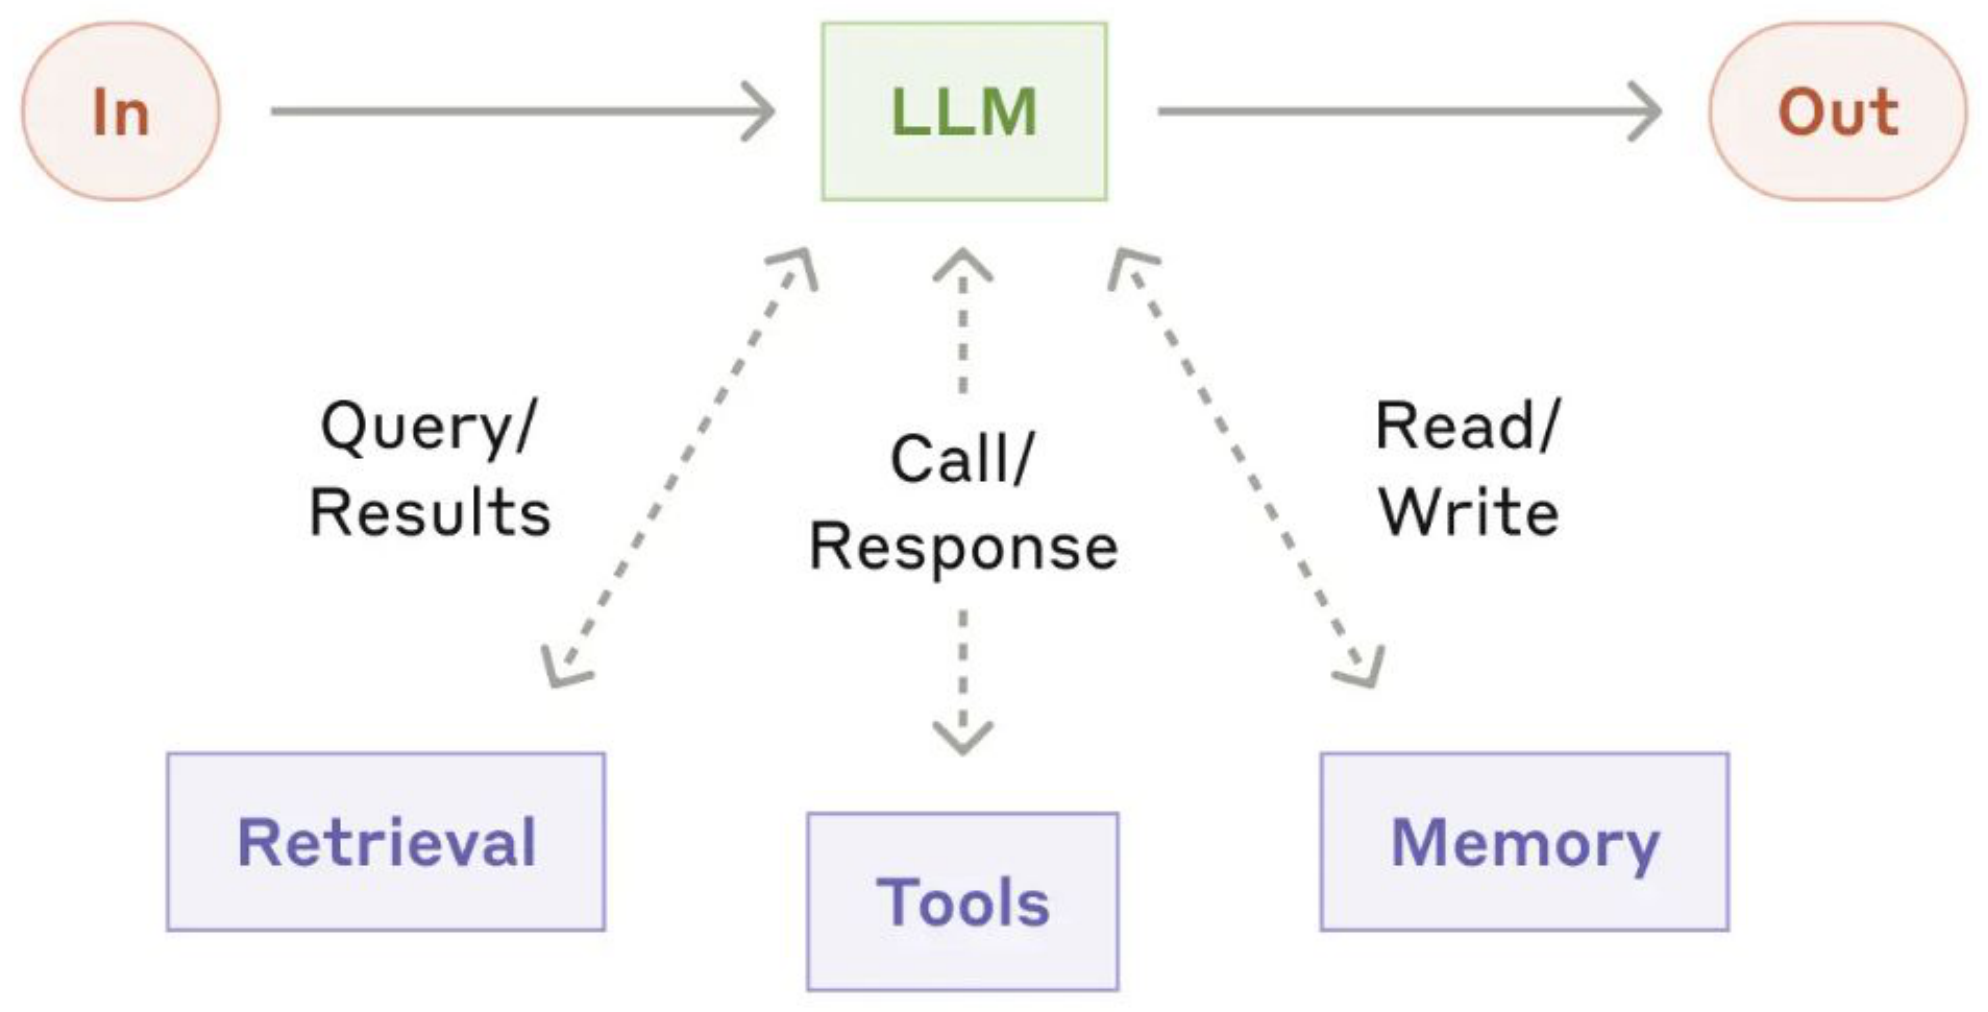
Les modèles peuvent recommencer. Un système n’a plus à répondre une seule fois puis à s’arrêter. Il peut planifier, agir, examiner le résultat et recommencer jusqu’à ce que la tâche soit terminée.
Réunissez ces éléments et vous obtenez ce qu’on appelle un agent. Un agent est un modèle doté d’outils et d’une mémoire qui travaille jusqu’à ce qu’une tâche soit terminée. Il agit dans les limites des autorisations qu’une personne lui a données. Il n’a aucun discernement et ne peut pas être tenu responsable. Il a une tâche et des autorisations, rien de plus.
6.1Trois façons de travailler
Discussion. Vous posez une question, le système répond, vous vérifiez. Utile pour rédiger, traduire, expliquer et s’entraîner.
Recherche. Le système cherche d’abord dans un ensemble défini de documents, puis répond et montre ses sources. Utilisez-le pour tout fait lié à la négociation : évolution d’un texte, propos des Parties, décisions passées.11Si un système vous dit ce qu’un paragraphe d’une décision contient sans pouvoir vous le montrer, traitez sa réponse comme une rumeur.
Agent. Le système accomplit une tâche en plusieurs étapes à l’aide d’outils. Utilisez-le pour des tâches répétitives dont vous pouvez vérifier le résultat, comme suivre les changements entre versions ou préparer une note quotidienne.
6.2Cas d’usage
- Suivi des changements du texte
Compare la révision 3 de ce projet de décision avec la révision 2. Liste chaque changement de fond, cite les deux versions et signale les changements qui touchent aux lignes rouges de ma délégation.
Configuration: Fichiers joints - Tableau des positions
À partir de ces communications, dresse un tableau des positions des Parties sur l’article 6.4, avec une citation et une référence par ligne. Signale toute position que tu as déduite.
Configuration: Recherche documentaire - Suivi historique
Retrace les précisions apportées à l’expression « responsabilités communes mais différenciées » dans les décisions depuis 2015, en citant chaque décision.
Configuration: Recherche documentaire - Lecture du soir
Voici les quatre textes publiés aujourd’hui. Dis-moi ce qui a avancé, ce qui a bloqué et quelles sont les trois pages à lire avant demain.
Configuration: Fichiers joints - Résumé quotidien
Chaque soir, rassemble les textes du jour publiés dans les volets de négociation que je suis, résume les changements et envoie-moi la liste.
Configuration: Agent programmé - Lecture des crochets
Pour chaque option entre crochets dans ce paragraphe, explique à qui elle profite, qui s’y oppose et quelle pourrait être une formulation de repli.
Configuration: Fichiers joints - Entraînement
Joue le rôle d’un négociateur qui s’oppose à ce texte. Conteste mon intervention, sans chercher à me faire plaisir.
Configuration: Discussion - Traduction aller-retour
Traduis ma formulation en français, puis retraduis-la en anglais de façon indépendante et dis-moi ce qui a changé de sens.
Configuration: Discussion - Passage de relais
À partir de mes notes de cette session, rédige le document de passation pour la personne qui reprendra ce dossier au prochain cycle.
Configuration: Fichiers joints - Travail sur les données
À partir de ce tableur sur les émissions, trace leur évolution pour ces pays depuis 2010, précise ta méthode et liste chaque hypothèse sur les données manquantes.
Configuration: Accès aux fichiers
6.3Travailler avec un agent en toute sécurité
Quand un outil de discussion vous comprend mal, vous obtenez un mauvais paragraphe. Quand un agent vous comprend mal, il peut agir sur la base de cette erreur.
Vérifiez tout ce que vous comptez reprendre. Ouvrez un document cité et vérifiez que la citation y figure bien avant de l’utiliser en séance.
Donnez le moins d’autorisations possible. Un système qui lit vos fichiers n’a pas aussi besoin d’envoyer des courriels.
Méfiez-vous des documents externes. Un fichier soumis par quelqu’un d’autre peut contenir des instructions cachées destinées à l’agent.
Décidez qui valide. Convenez de la personne qui approuve tout texte rédigé avec l’aide de l’IA. Quand plusieurs outils interviennent, personne d’autre ne s’en chargera.
Agents pour les e-mails
Tri de la boîte mail, rédaction et suivi, délégués avec soin.
L’e-mail reste le principal moyen de communication au travail. Trois choses le rendent difficile à gérer.
Le volume. Les boîtes de réception débordent, et trier les messages prend du temps que vous n’avez pas.
Bien écrire. Rédiger un e-mail clair et court qui incite à agir demande du savoir-faire.
Les langues. Vous devez souvent écrire dans une langue qui n’est pas la vôtre.
Un assistant connecté à votre messagerie peut lire seul tout le fil de discussion. Autorisez-le à lire et à rédiger des brouillons. Gardez la main sur l’envoi.
- Suivi de réunion
Résume les points clés et les engagements de la dernière réunion de négociation, précise qui a pris chaque engagement et rédige un e-mail de suivi poli aux participants sur les actions convenues.
- Planification
Rédige un e-mail poli et souple proposant plusieurs dates et horaires pour la prochaine série de réunions, dans le fuseau horaire de chaque participant.
- Point quotidien
Rédige un court e-mail quotidien sur les avancées des dernières sessions : nouvelles propositions, points d’accord et points encore en désaccord.
- Définir les priorités
Rédige un e-mail à l’équipe de négociation proposant de classer les points de l’ordre du jour selon leur urgence, leur effet sur les objectifs climatiques et les chances d’accord.
- Trier la boîte de réception
Regroupe mes messages non lus en quatre catégories : décision de ma part requise, réponse requise, transfert requis, aucune action requise. Prépare des réponses pour le troisième groupe uniquement, sans les envoyer.
- Vérifier le ton
Réécris cet e-mail dans un langage diplomatique formel sans modifier aucun engagement de fond, puis liste tes modifications pour que je puisse les vérifier.
Ces systèmes ont tendance à adopter un ton chaleureux et conciliant. Ce ton peut faire des concessions que votre texte d’origine ne faisait pas. Demandez au modèle ce qu’il a changé et lisez la liste.
Des agents pour la logistique
Agendas, listes de contrôle et voyages. Le travail à faible risque que les agents font bien.
Pendant une session, les plannings, les listes de tâches et les réservations de voyage s'accumulent vite. Trois problèmes reviennent sans cesse.
Le temps. Il est difficile de décider quoi faire en premier et combien de temps y consacrer.
Les tâches oubliées. Des points importants disparaissent de la liste.
Les voyages. Trouver des vols et des hôtels adaptés à votre planning et à votre budget prend des heures.
Ces tâches sont les moins risquées du guide et le meilleur point de départ pour utiliser un agent. Elles se répètent, leurs résultats sont faciles à vérifier et très peu sont confidentielles.
- Réservations
Trouve les vols et les hôtels les moins chers et les plus pratiques pour un voyage de [ville de départ] à [ville de destination] aux [dates]. Je préfère les vols du matin et un hôtel proche du lieu de la session. Montre-moi les compromis plutôt qu'une seule recommandation.
- Listes de contrôle
Prépare une liste de contrôle complète pour une session internationale de deux semaines : documents, accréditation, vêtements pour une météo variable, matériel de travail et copies hors ligne des textes clés.
- Planifier la journée
Consulte mon agenda et le programme de la session, puis propose un planning avec des réunions, du temps pour mon travail, du sport et du temps personnel, en tenant compte de ces échéances et engagements.
- Suivre les progrès
Crée un modèle pour suivre les chantiers dont je m'occupe, avec des étapes clés, des échéances et un espace pour les mises à jour et les prochaines étapes.
C'est aussi pour la logistique que vous donnerez d'abord à un agent un accès réel à votre agenda, à vos e-mails et à vos fichiers. C'est normal. Mais c'est aussi là que commence l'habitude d'élargir un peu cet accès à chaque fois. Le système qui réserve vos vols n'a pas besoin de rédiger vos positions.
Des agents pour d’autres activités
Bien-être, culture et côté humain d'une session, avec des limites honnêtes.
Les négociations climatiques concernent autant les personnes que les faits. Les émotions, les différences culturelles et la santé mentale jouent toutes un rôle.
Santé mentale. Le changement climatique et la pression des négociations épuisent les délégués.
Malentendus culturels. Des personnes de cultures différentes peuvent mal se comprendre. Cela crée des tensions et ralentit les discussions.
Dans cette seule partie du guide, une simple fenêtre de discussion vaut mieux qu’un agent. Il s’agit de conversations. Elles ne nécessitent pas de système ayant accès à vos fichiers.
- Repères culturels
Je participe à une négociation de l’ONU sur le changement climatique avec une personne du Kenya. Quels aspects culturels dois-je connaître pour faire avancer ma négociation ?
- Un peu de réconfort
J’ai le moral bas en ce moment, peux-tu me dire quelque chose de réconfortant ?
- Bilan
Voici ce qui s’est passé pendant cette séance et comment j’ai réagi. Qu’aurait fait autrement un négociateur plus expérimenté ?
Deux mises en garde. D’abord, les repères culturels décrivent un pays en général, mais vous parlerez à une personne. Utilisez-les pour comprendre le contexte, pas pour prédire son comportement. Ensuite, un modèle peut servir à poser une idée à une heure du matin. Mais ce n’est ni un médecin ni un collègue, et l’échange n’est pas confidentiel. Si vous ressentez plus que de la fatigue, parlez à votre chef de délégation, aux personnes chargées du soutien dans votre programme ou à un professionnel.
Souveraineté : qui possède quoi
À qui appartiennent les mots, les données et les décisions quand un modèle est dans la salle. Une page.
Ces outils peuvent rééquilibrer les négociations multilatérales. Ils réduisent la barrière de la langue qui détermine qui parle avec assurance. Ils raccourcissent des documents que personne n’a le temps de lire. Ils donnent à une délégation de deux personnes une partie des moyens d’une délégation de cinquante. C’est précieux. Mais avant de taper, posez-vous quelques questions.
À qui appartiennent les données ? Le texte que vous collez dans un assistant en ligne quitte votre délégation. Selon le compte et ses paramètres, l’entreprise peut le garder, le faire lire à son personnel ou l’utiliser pour entraîner son prochain modèle. Les positions nationales, les instructions de votre capitale et les confidences reçues n’y ont pas leur place.
Qui décide ? Un modèle écrit un texte qui ressemble à une position. S’il rédige sans que personne ne vérifie, la réflexion sur la position de votre pays commence à se faire hors de votre délégation. Chaque texte qui en sort doit être assumé par une personne ayant un mandat.
Que ne pouvez-vous pas voir ? OpenAI et Anthropic ne montrent pas tout le raisonnement du modèle. Vous recevez une réponse, et parfois un résumé du chemin suivi. Les étapes réelles restent chez l’entreprise. Vous ne pouvez ni les vérifier, ni les reproduire, ni montrer à un collègue pourquoi le système a donné cette réponse.
Poids ouverts ou fermés ? Les poids d’un modèle sont les valeurs numériques apprises pendant son entraînement. ChatGPT, Claude et Gemini gardent les leurs sur les ordinateurs de leurs entreprises. Ce sont les modèles les plus puissants et les plus faciles à utiliser. Llama, Mistral, Qwen, Gemma et DeepSeek publient les leurs. Vous pouvez donc faire tourner le modèle sur votre ordinateur ou sur un serveur de votre région. Les modèles ouverts traduisent, résument et rédigent bien. Ils sont moins bons pour les problèmes les plus difficiles à plusieurs étapes. Et si vous détenez les poids, personne ne peut augmenter le prix ou couper le modèle en pleine session.
Une IA respectueuse de la souveraineté laisse la délégation, la région ou la communauté fixer les conditions. Elles choisissent le modèle, les données qu’il reçoit et qui peut vérifier ce qu’il a fait. Elles peuvent aussi dire non. Dans le processus des COP, les Parties qui ont le moins de capacités ont souvent le plus à perdre. C’est donc une question concrète.
Une règle pratique. Utilisez le modèle en ligne le plus puissant pour les contenus publics, les lectures de fond, la rédaction et les exercices. Pour tout ce qui touche à une position encore non publique, utilisez un modèle à poids ouverts ou un service régi par un contrat que votre institution a lu.
Ce guide aide à garder ce compromis à l’esprit. Les chapitres précédents montrent ce que ces systèmes font bien. Celui-ci montre ce que vous cédez en échange.
Déployer votre propre IA souveraine
Faire tourner soi-même un modèle à poids ouverts : quoi exécuter, ce que coûte le matériel, et comment l'installer.
Le chapitre précédent a présenté le compromis. La meilleure réponse est de faire fonctionner le modèle vous-même.
Quand vous hébergez votre propre modèle, rien ne quitte vos locaux. Vous n'avez pas à faire confiance à la politique d'une entreprise sur les données. Aucune condition d'utilisation ne peut changer à votre insu. Aucun compte ne peut être suspendu en pleine session. Et votre institution acquiert elle-même les compétences au lieu de les louer.
Jusqu'à récemment, faire fonctionner son propre modèle obligeait à accepter un modèle bien plus faible. Ce n'est plus le cas.
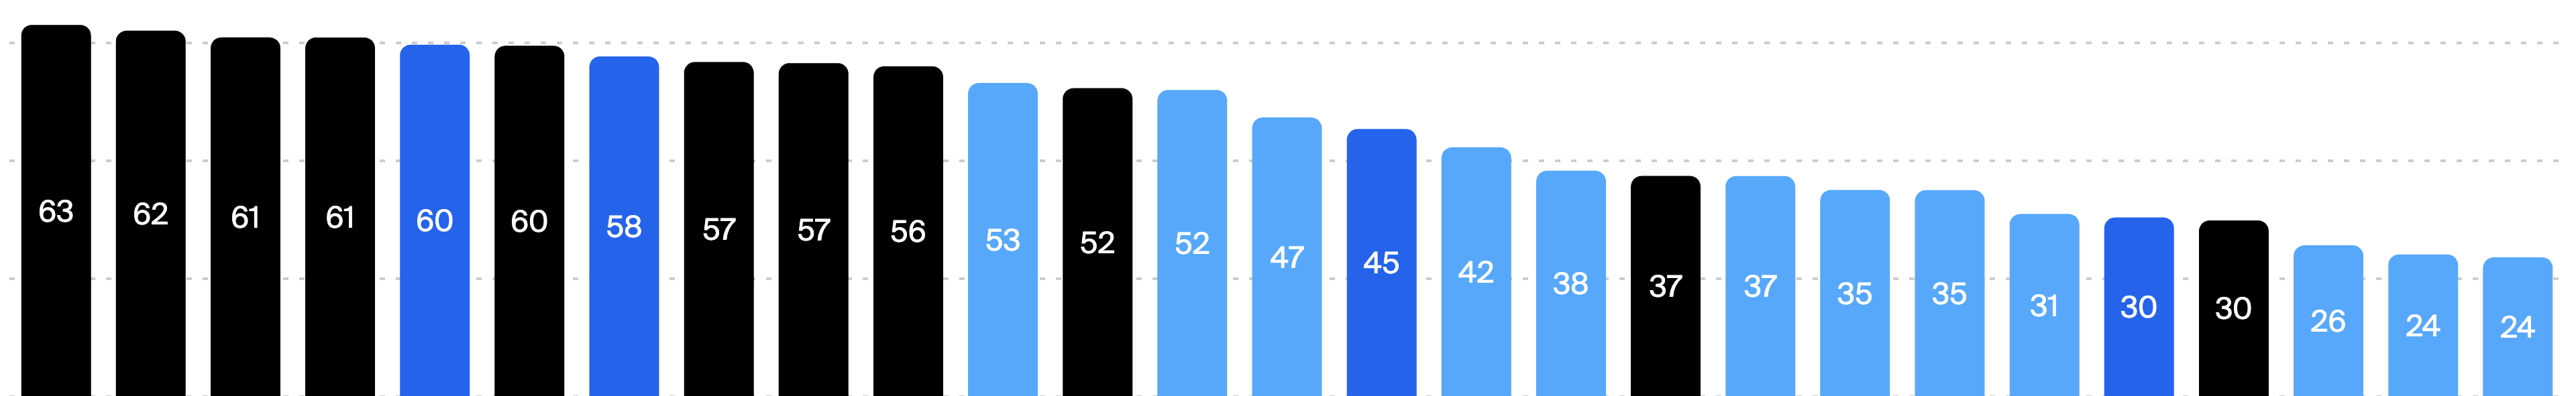
Artificial Analysis publie un indice d'intelligence qui évalue les modèles sur un même ensemble de tests. Kimi K3 et GLM-5.3 obtiennent tous deux 60 points, trois points derrière Claude Opus 5 à 63. Qwen3.8 suit à 58. Dix-neuf des 29 modèles de l'indice ont des poids ouverts, même si les modèles fermés occupent encore la plupart des premières places.11Le graphique classe GLM-5.3 et GLM-5.3-Flash comme propriétaires. Z.ai publie les poids des deux modèles sous licence MIT. Ce livre les compte donc comme ouverts, d'où les dix-sept barres bleues sur la figure et les dix-neuf modèles dans le texte. Il y a un an, le meilleur modèle ouvert avait treize points de retard sur le meilleur modèle fermé. L'écart s'est vite réduit et pourrait encore se réduire.
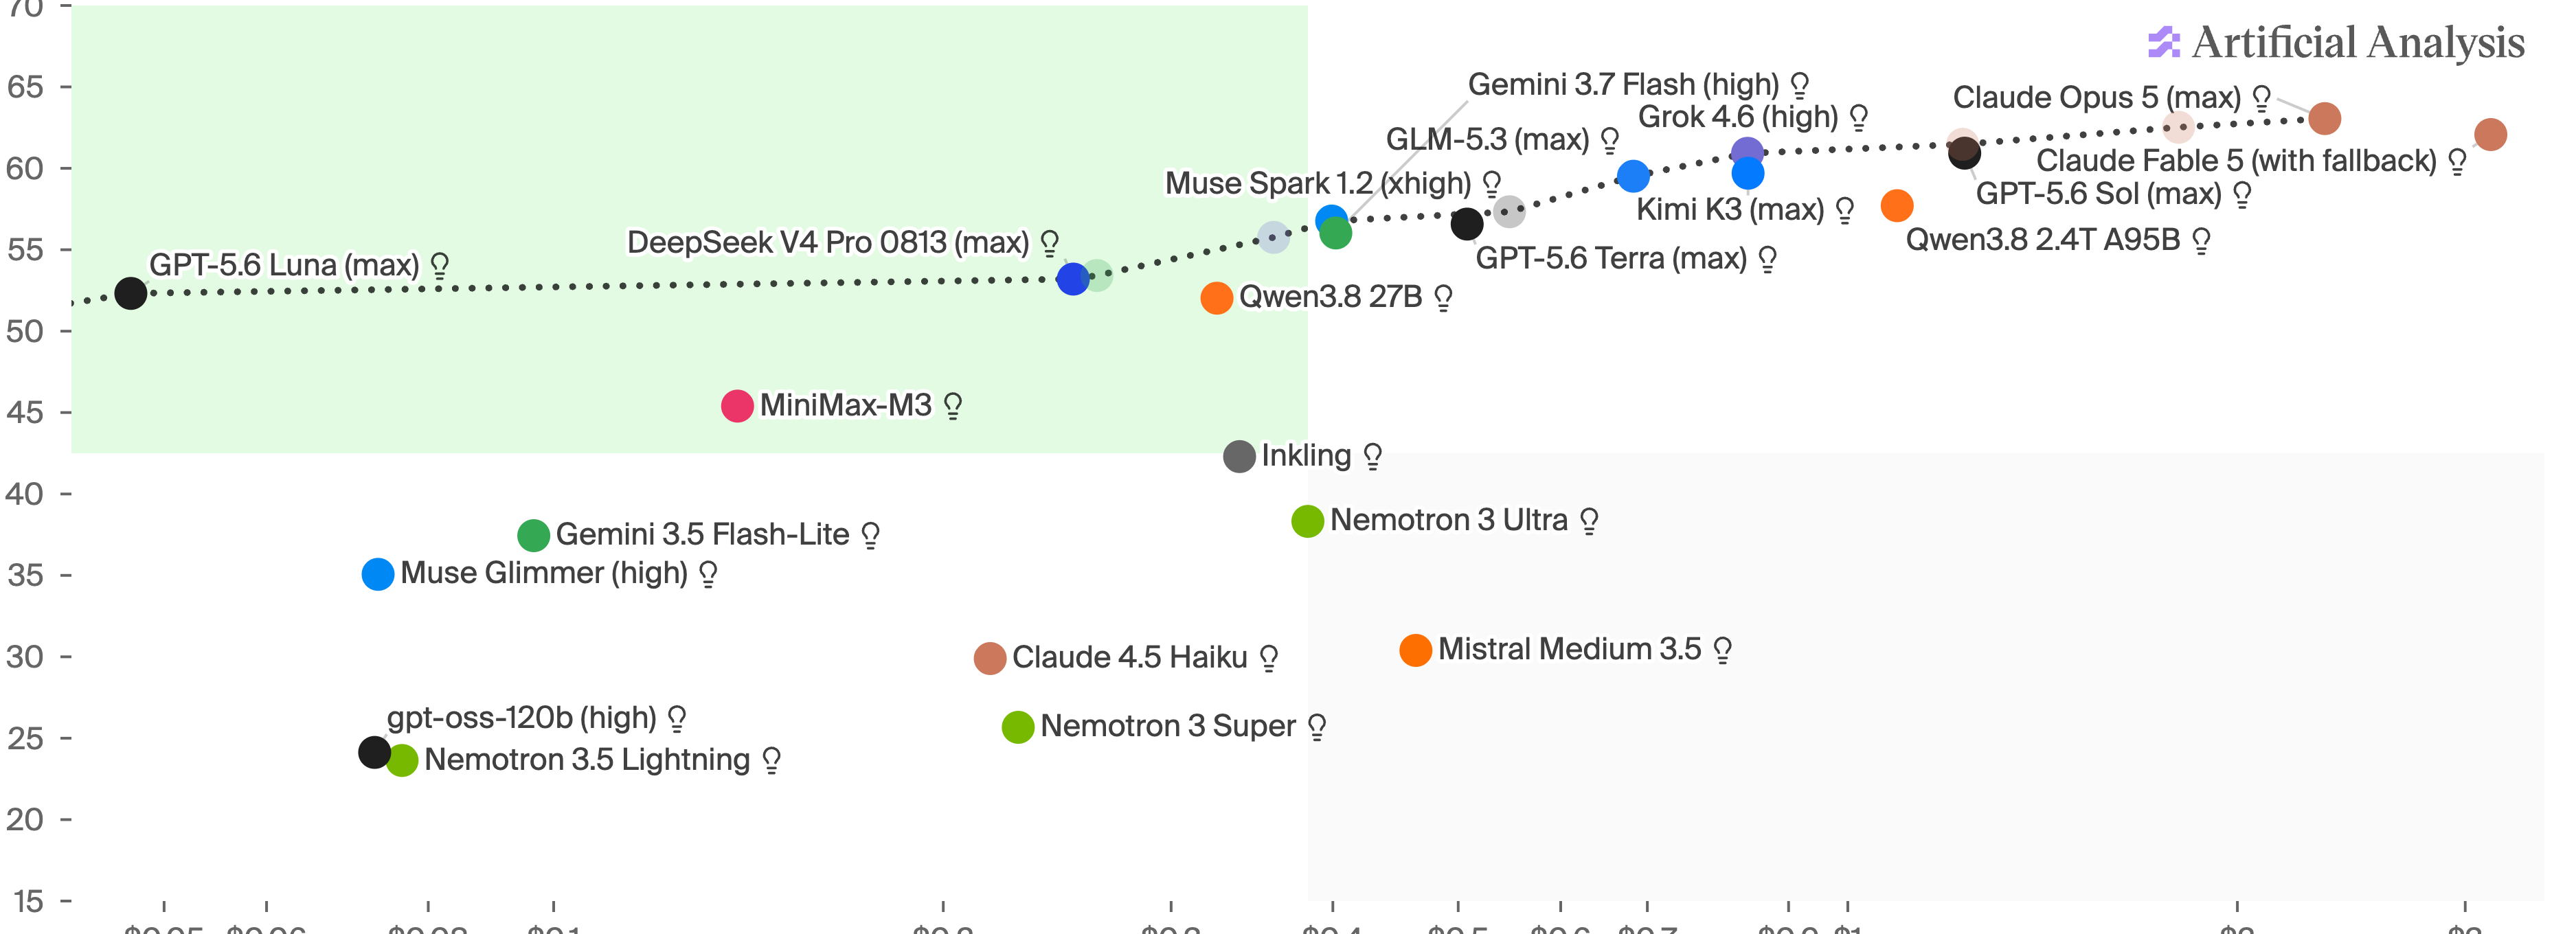
Le prix est l'autre moitié de l'argument. GLM-5.3-Flash obtient 57 points pour environ neuf centimes de dollar par tâche. DeepSeek V4 Pro 0813 obtient 53 points pour environ un quart de dollar. Tous deux se trouvent dans la zone à score élevé et à faible coût. Claude Opus 5 obtient 63 points, mais coûte environ dix fois plus que DeepSeek. Cette différence permet à une délégation de financer son propre modèle.
11.1Quel modèle choisir
| Modèle | Laboratoire | Poids | Indice |
|---|---|---|---|
| Kimi K3 (max) | Moonshot | Ouverts, usage restreint | 60 |
| GLM-5.3 (max) | Z.ai | Ouverts, MIT | 60 |
| Qwen3.8 2.4T A95B | Alibaba | Ouverts, usage restreint | 58 |
| GLM-5.3-Flash | Z.ai | Ouverts, MIT | 57 |
| DeepSeek V4 Pro 0813 | DeepSeek | Ouverts | 53 |
| Qwen3.8 27B | Alibaba | Ouverts | 52 |
| MiniMax-M3 | MiniMax | Ouverts, usage restreint | 45 |
| Nemotron 3 Super | NVIDIA | Ouverts | 26 |
| gpt-oss-120b (high) | OpenAI | Ouverts | 24 |
Au 26 août 2026. Lisez la licence avant de choisir. Plusieurs des meilleurs modèles ouverts limitent l'usage commercial. Pour une délégation, cela convient généralement. Pour une entreprise qui crée un produit à partir de l'un d'eux, ce n'est pas le cas.
11.2Combien cela coûte
Un NVIDIA DGX Spark est un ordinateur de bureau doté de 128 Go de mémoire. Il coûte aujourd'hui 4 699 dollars. Vous pouvez en relier deux directement pour obtenir 256 Go pour environ 9 400 dollars. Cette paire peut faire fonctionner un grand modèle comme DeepSeek à 55 à 60 tokens par seconde, plus vite que vous ne pouvez lire. Elle peut aussi contenir environ un million de tokens de texte à la fois, soit plusieurs milliers de pages. Cela suffit au travail d'une délégation.
Un seul appareil peut faire fonctionner un modèle plus petit (27 à 35 milliards de paramètres) assez vite pour soixante personnes à la fois. Cela couvre la traduction, les résumés et la rédaction pour tout un bureau. Trois ou quatre appareils, avec 384 à 512 Go, peuvent faire fonctionner les plus grands modèles ouverts dans leur intégralité.
Comparez cela au prix d'un abonnement pour chaque délégué. Le matériel est amorti en un ou deux cycles de négociation et continue de fonctionner après la fin du financement.
11.3Comment l'installer
Faites fonctionner le modèle avec un logiciel appelé vLLM ou SGLang. Tous deux fonctionnent comme le service d'OpenAI. Tout outil compatible avec ChatGPT fonctionnera donc avec votre propre serveur une fois l'adresse et la clé modifiées. Pour un premier essai sur un ordinateur portable, Ollama ou llama.cpp sont plus simples. NVIDIA publie des guides d'installation pour le Spark, et des guides publics de la communauté expliquent comment relier deux, trois ou quatre appareils.
Si vous ne pouvez pas faire fonctionner votre propre modèle avant la prochaine session, utilisez un service en ligne qui a signé un accord de non-conservation des données. C'est un engagement écrit à ne pas stocker ce que vous envoyez. Considérez-le comme une solution temporaire.
11.4Une limite à connaître
L'indice ci-dessus fait la moyenne de neuf tests différents, et le retard des modèles ouverts varie selon le test. L'écart est le plus grand sur les tâches de raisonnement les plus difficiles et sur les hallucinations. Sur ces deux points, les modèles fermés restent nettement en tête. Pour un négociateur, les hallucinations comptent le plus. Orientez donc le modèle vers vos propres documents, demandez des sources et ouvrez-les.
L’IA civique
Utiliser un modèle pour écouter toute une circonscription. Les outils qui le font déjà, et leurs limites.
Le chapitre précédent se terminait avec un modèle sur votre propre matériel. Celui-ci explique comment l’utiliser pour écouter votre population.
Jusqu’ici, ce guide a présenté l’IA comme un outil de travail individuel. Il existe un second usage. Il change ce qu’une petite délégation ou un groupe de jeunes peut faire. Un modèle peut vous aider à écouter bien plus de personnes qu’une équipe humaine. Vous pouvez ensuite porter leurs paroles dans la salle, preuves à l’appui.
C’est ce qu’on appelle l’écoute à grande échelle. Un sondage enferme les gens dans des réponses écrites par d’autres. L’écoute à grande échelle fait l’inverse. Les gens répondent avec leurs propres mots. Un logiciel repère les points communs dans les réponses. Il les soumet ensuite aux personnes qui les ont écrites, pour qu’elles puissent les corriger.
12.1Polis, le plus ancien de ces outils
Polis est un sondage qui fonctionne comme une conversation. Les gens écrivent de courtes affirmations. Les autres votent pour, contre ou passent sur des affirmations choisies en partie au hasard. Le système regroupe les votants selon leurs votes. Il met ensuite en avant les affirmations qui font consensus entre les groupes, plutôt que celles qui obtiennent une simple majorité.
Taïwan est l’exemple le plus connu. Après les manifestations du mouvement des Tournesols en 2014, la communauté de technologie civique g0v et le gouvernement ont lancé vTaiwan sur Polis. Plus de 200,000 personnes ont participé à ses consultations. Une consultation sur les applications de VTC comme Uber a dégagé des affirmations partagées par les chauffeurs, les compagnies de taxis et les passagers. La réglementation a ensuite été rédigée à partir de ces affirmations.
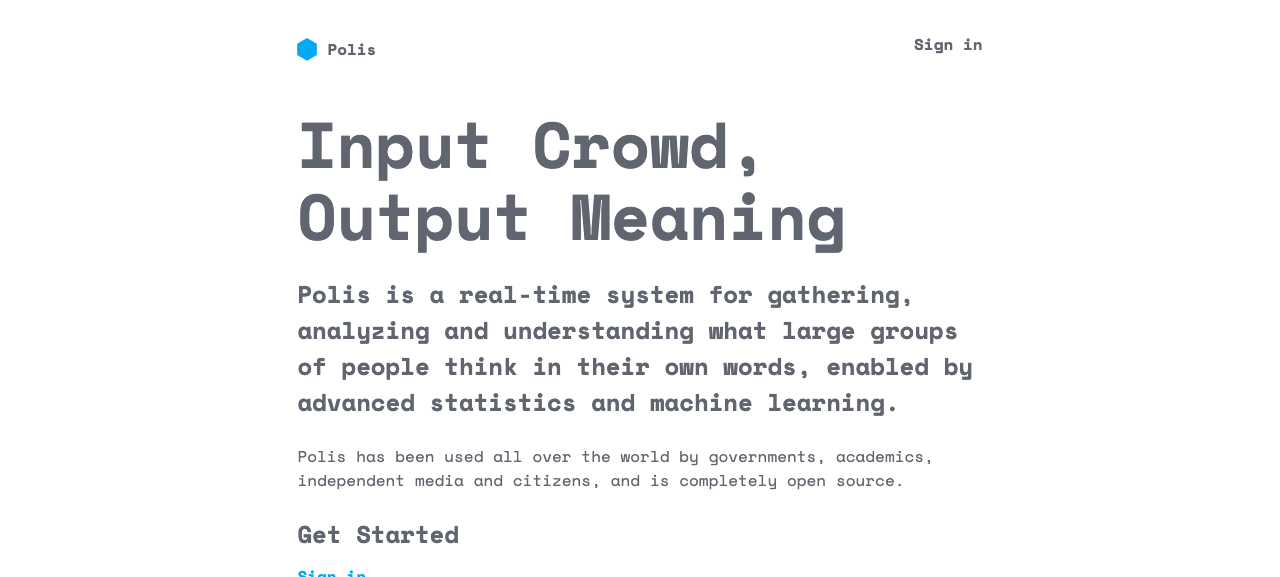
Polis est gratuit et open source (licence AGPL). Le Computational Democracy Project en assure la maintenance. Il est plus ancien que les modèles de langage actuels et n’en utilise aucun. C’est en partie pour cela qu’il fonctionne toujours bien.
12.2Talk to the City et l’apport des modèles
Talk to the City ajoute un modèle de langage pour faire la lecture. L’AI Objectives Institute l’a créé. Il traite des entretiens, des réponses à des sondages, des messages de forums ou des transcriptions. Il les découpe en affirmations, les classe par thème et rédige un rapport. Chaque ligne du rapport renvoie à la citation dont elle est tirée. Les versions récentes mènent aussi les entretiens. Elles posent des questions de suivi comme le ferait une personne, au lieu de lire une liste fixe.11Un projet a utilisé un modérateur IA pour interroger 81,000 personnes dans le monde. Le modèle rebondissait sur les points soulevés par chaque participant. Cette échelle est réelle, tout comme la réserve ci-dessous : le modèle décide quoi demander et quoi garder.
Ces liens vers la source sont essentiels. Un résumé que personne ne peut vérifier n’est qu’une affirmation. Talk to the City est open source (licence Apache), et vous pouvez l’exécuter vous-même.
12.3Team Mirai, la version qui siège au parlement
Takahiro Anno est ingénieur logiciel et auteur de science-fiction. En 2024, il s’est présenté au poste de gouverneur de Tokyo sans parti et a obtenu 154,000 voix. Pendant une diffusion en direct de dix-sept jours, un avatar IA entraîné sur son programme a répondu à 8,600 questions d’électeurs. En mai 2025, il a fondé un parti, Team Mirai. Celui-ci a obtenu un siège à la chambre haute en juillet, puis onze à la chambre basse en février 2026, avec environ sept pour cent des voix.
C’est le système derrière ce résultat qui mérite d’être repris. Un citoyen parle à un outil d’entretien par IA. Celui-ci pose des questions de suivi et transforme la conversation en projet de proposition politique. Le parti ne reçoit le projet que si le citoyen confirme qu’il reflète ses propos. Quand assez de personnes soutiennent une idée, elle devient une proposition que les parlementaires du parti peuvent déposer. Lors d’une consultation, l’outil a recueilli plus de 1,200 heures de conversation en quelques jours. Une personne aurait besoin d’environ cinquante jours sans dormir pour faire de même.
Deux choix de conception comptent surtout. D’abord, le citoyen donne l’accord final : le modèle ne peut donc pas changer ses propos en douce. Ensuite, le parti ne prend pas position sur les questions qui divisent profondément. Il les soumet à un vote direct, car aucun logiciel ne peut effacer un vrai conflit d’intérêts.
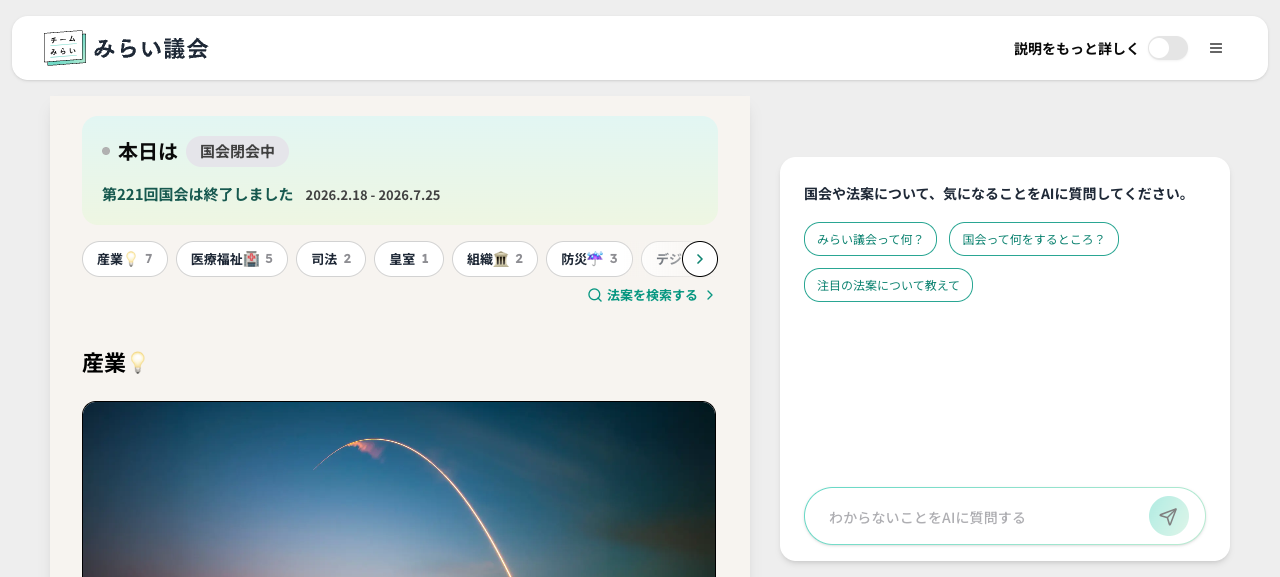
Leur logiciel d’écoute à grande échelle, kouchou-ai, est open source. Au départ, c’était une version de Talk to the City adaptée aux municipalités japonaises. Pour une délégation, mieux vaut adapter ouvertement un outil public existant aux besoins locaux que payer pour en créer un nouveau.
12.4Trois autres outils à connaître
Agora Citizen Network. Une version entièrement open source du regroupement à la Polis, conçue pour le web ouvert. Elle passe à l’AT Protocol, une norme ouverte pour les données sociales. Ainsi, une discussion ne reste pas enfermée dans la base de données d’une entreprise. En septembre 2025, pendant la grève bloquons tout, une équipe française y a lancé une consultation nationale. Elle voulait voir si un pays en colère pouvait encore trouver des affirmations partagées.
Habermolt. Une expérience de recherche qui prend le chemin inverse. Elle ne cherche pas à écouter plus de gens. Elle donne à chacun un agent IA qui apprend ses opinions et débat pour lui dans des réunions auxquelles il n’assiste jamais. Vous lisez ce que votre agent a dit et le corrigez. Le système repose sur la Habermas Machine de DeepMind. C’est une piste de recherche, pas un outil abouti. Un agent qui parle pour vous est précisément ce dont le chapitre 10 invite à se méfier.
Simocracy. GainForest, qui coédite ce guide, l’a créé. Lisez donc ceci comme un exemple, pas une recommandation. Chaque participant écrit un « sim ». Un sim a un avatar, une constitution qui précise ce qu’il défend et ses lignes rouges, et une façon de parler. Le sim est stocké sur l’AT Protocol, appartient à la personne qui l’a écrit et assiste aux réunions pour elle. Les groupes discutent des propositions en public, avec une trace écrite, et décident comment répartir un budget commun. L’outil a été utilisé avec Funding the Commons à Frontier Tower à San Francisco et dans l’expérience Agent Village. Dans les deux cas, les gens ont pris la décision finale de financement.
12.5À quoi cela sert lors d’une COP
Une position de groupe. YOUNGO, le groupe des jeunes, compte des centaines de membres dans tous les fuseaux horaires et dispose de quelques jours pour s’accorder sur une position. L’écoute à grande échelle remplace un appel auquel personne ne peut participer par un texte que chacun peut vérifier.
Un appel à contributions. À la clôture du dépôt, 180 documents sont soumis et aucune délégation ne les a lus. Regroupez les affirmations, gardez les citations et ouvrez les documents qui comptent.
Une délégation de deux personnes. Il y a souvent un écart entre votre mandat et ce que la population de votre pays souhaite vraiment. L’écoute à grande échelle réduit cet écart à peu de frais entre les sessions.
Rendre compte. Après une session, faites le même travail en sens inverse. Expliquez les décisions et leurs effets locaux, et écoutez les réactions.
12.6Que vérifier avant de se lancer
Qui a écrit les questions ? Un modèle qui mène des entretiens décide quoi demander, quoi garder et comment en rendre compte. Cela lui donne un vrai pouvoir sur le résultat. Publiez le prompt et la liste des thèmes, comme vous publieriez un questionnaire.
Les participants vérifient leurs propres propos. Rien n’entre dans le compte rendu tant que la personne concernée n’a pas validé le résumé. Cette règle empêche une machine de faire dire aux gens ce qu’ils n’ont pas dit.
La langue. Ces outils fonctionnent dans les langues que les gens parlent vraiment. C’est leur grand avantage sur une consultation menée seulement en anglais. Vérifiez les résultats dans chaque langue. Ne commencez pas par tout traduire en anglais.
N’inventez pas des gens que vous pourriez consulter. Les participants générés par IA coûtent peu, mais ne prouvent rien. Si un groupe est concerné, consacrez les fonds nécessaires pour le joindre.
Hébergez vous-même les données sensibles. Polis, Talk to the City, kouchou-ai, Agora et Simocracy sont tous open source. Le chapitre 11 explique comment les exécuter sur votre propre matériel.
L’empreinte environnementale
Votre usage est petit. Le total de l'industrie est le chiffre sérieux. Voici le calcul pour les deux.
L’IA consomme de l’énergie et de l’eau. Un négociateur climatique qui l’utilise devrait pouvoir dire combien. Votre propre consommation est faible. La demande totale est forte et augmente. Il faut dire les deux. N’en dire qu’un, c’est souvent ce qui fausse le débat.
13.1Votre propre consommation est faible
Google a mesuré la consommation d’une requête textuelle type à Gemini : 0,24 Wh d’énergie, 0,03 gramme de CO2e et 0,26 millilitre d’eau.11Google, Measuring the environmental impact of delivering AI at Google scale, arXiv:2508.15734, août 2025. Ce chiffre inclut la capacité inutilisée et les besoins annexes des centres de données, que la plupart des estimations publiées omettent. C’est à peu près autant que faire tourner un ordinateur portable quelques secondes. Même une journée entière d’usage intensif consomme moins qu’un court trajet en voiture.
Polly affiche ce chiffre pour chaque compte et publie sa méthode de calcul.22La méthode et toutes les constantes sont dans footprint.ts dans pi-village-core. Un chiffre qu’un négociateur ne peut pas examiner vaut moins que l’absence de chiffre. Le calcul part de la part du modèle active pour chaque mot traité :
Lire votre requête consomme environ quatre fois moins qu’écrire la réponse. Relire une requête que le système a déjà vue consomme dix fois moins. Les trois sont donc comptés séparément. Polly utilise un modèle qui active 18 milliards de ses paramètres pour chaque token. Avec ce modèle, un échange type consomme environ 0,10 Wh et 0,11 millilitre d’eau. C’est moins que le chiffre de Google.33La constante en joules par token est calibrée sur le banc d’essai ML.ENERGY, qui mesure directement la consommation des GPU dans 1 858 configurations de service, au lieu d’être supposée. Cela a réduit l’estimation de moitié : l’hypothèse précédente sous-estimait la capacité d’un serveur très sollicité à regrouper les tâches.
Considérez tous ces chiffres comme exacts à un facteur deux près. Ils excluent l’énergie utilisée pour entraîner le modèle, l’eau utilisée pour produire l’électricité, votre propre appareil et le carbone émis pour fabriquer le matériel.
13.2La demande totale est forte
Une requête consomme peu. Des milliards de requêtes, beaucoup plus, et davantage de personnes en envoient chaque mois. Les centres de données font croître la demande d’électricité plus vite que les réseaux ne passent aux énergies propres. De nouveaux centres de données se construisent dans des régions qui manquent déjà d’eau. Et les entreprises qui publient ces faibles chiffres par requête ont vu leurs émissions totales augmenter depuis qu’elles ont commencé à construire ces systèmes.
Le chiffre par requête exclut aussi l’entraînement, qui consomme beaucoup. Avant qu’un modèle de pointe réponde à une seule question, son entraînement consomme des gigawattheures d’électricité. Ce coût est réparti sur toutes les requêtes auxquelles le modèle répondra. Il disparaît donc dans le chiffre par requête, mais reste élevé à l’échelle nationale.
Votre propre consommation est faible. Elle s’inscrit dans une demande totale forte et croissante en énergie, en eau et en terres. Présenter la première sans la seconde relève d’une comptabilité qu’un négociateur n’accepterait jamais d’une autre Partie.
13.3Que faire ?
Désactivez le raisonnement quand vous n’en avez pas besoin. C’est ce qui a le plus d’effet, et ce n’est qu’un réglage. Le même modèle avec le raisonnement activé peut utiliser vingt à quarante fois plus de tokens, et la consommation d’énergie augmente avec leur nombre. La traduction, les résumés et les changements de format n’ont presque jamais besoin de raisonnement.
Ensuite, choisissez un modèle plus petit. Certains modèles n’utilisent que quelques milliards de leurs paramètres pour chaque token. Ils consomment bien moins qu’un modèle qui utilise tous ses paramètres. Ce que vous payez en énergie, c’est la partie active du modèle, pas sa taille annoncée.
Ne prenez pas le prix comme indicateur de l’empreinte. Parmi les modèles ouverts qui publient assez de données pour le vérifier, le prix et la consommation d’énergie évoluent bien ensemble. Mais le prix par unité de calcul varie d’un facteur soixante. Deux modèles peuvent coûter autant à utiliser alors que l’un consomme plusieurs fois plus d’énergie.
Demandez aux fournisseurs leurs chiffres, y compris pour l’eau. Demandez quel réseau électrique alimente le traitement de vos requêtes. Ce sont des questions légitimes à poser à un fournisseur, et peu de gens les posent.
Publiez votre propre chiffre quand vous utilisez ces outils au travail. Une délégation qui publie l’empreinte de son propre usage de l’IA peut légitimement demander aux autres de faire de même.
Conclusion et recommandations
Forces, faiblesses et recommandations pour les négociateurs et leurs programmes.
14.1Forces et faiblesses
Forces. Les modèles lisent et résument vite les grandes quantités de texte sur lesquelles repose la politique climatique. Ils peuvent rédiger des rapports, préparer des politiques et simuler des négociations en langage simple, ce qui fait gagner du temps et de l’argent. Ils peuvent aider beaucoup de personnes à la fois : responsables politiques, chercheurs et militants.
Faiblesses. Les modèles peuvent avoir des biais qui orientent leurs réponses si personne ne les vérifie et ne les corrige. Leur qualité dépend des données d’apprentissage, ce qui limite leur capacité à traiter les nuances des questions climatiques. Sans vérification humaine, ils interprètent souvent mal le langage juridique et technique complexe.
Possibilités. Des messages adaptés aux différents groupes qui travaillent sur le climat. Des liens avec d’autres outils d’analyse des données environnementales, pour de meilleures politiques. Des explications sur la politique climatique pour les non-spécialistes.
Menaces. La désinformation, quand un modèle produit du contenu faux ou trompeur à partir de mauvaises sources. Une dépendance excessive, qui empêche de développer une expertise locale en politique climatique. Un manque de transparence et de responsabilité quand les machines aident à prendre des décisions.
Les agents ajoutent deux menaces. D’abord, les délégations riches utiliseront des systèmes bien gérés, et les plus petites des outils gratuits aux conditions floues. L’accès semble égal pour tous, mais l’écart se creuse. Ensuite, quand plusieurs personnes et outils travaillent sur un texte, il devient difficile de dire qui en est responsable. Décidez-le à l’avance.
14.2Recommandations
Trois choses méritent d’être créées : des outils qui traduisent le langage technique de l’UNFCCC, des plateformes qui analysent les négociations passées et un appui qui donne aux jeunes négociateurs la technologie nécessaire pour participer. Six autres méritent d’être ajoutées.
Compétences numériques. Des formations pour se repérer dans les bases de données et les sites web sur les politiques internationales.
Appui en direct. Des outils qui expliquent les choses pendant une négociation, au moment où vous en avez besoin, plutôt qu’après.
Entraînement à la négociation. Des simulations de négociations pour s’exercer à différentes situations.
Financement. Des plateformes de financement participatif ou de petites subventions pour aider les négociateurs à payer leur participation. Des négociateurs du Liberia et du Paraguay l’ont proposé.
Formation interculturelle. Des programmes sur les malentendus décrits par des négociateurs du Pérou et du Nigeria.
Mentorat. Des réseaux qui relient les jeunes négociateurs aux plus expérimentés, pour transmettre les connaissances d’un cycle à l’autre.
Pour un négociateur, quatre habitudes couvrent l’essentiel. Utilisez ces systèmes pour vous préparer, pour vous aider avec les langues et pour vous souvenir. Vérifiez tout ce que vous direz à voix haute. Ne laissez jamais un système parler au nom de votre Partie. Continuez à faire assez de recherches vous-même pour pouvoir vous passer d’aide.
Pour une délégation, précisez par écrit quels outils chacun peut utiliser, ce qu’il peut y coller et qui approuve un texte rédigé avec l’aide de l’IA. Une page suffit et coûte moins cher qu’une fuite.
Envoyez vos questions et commentaires à team@gainforest.net.
Références
Numérotées comme les notes de marge les citent.
- Le perceptron de Rosenblatt et la démonstration de 1958, Cornell Chronicle
- Krizhevsky, Sutskever, Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS 2012
- Vaswani et al., Attention Is All You Need, Google Research 2017
- Radford et al., Language Models are Unsupervised Multitask Learners, OpenAI 2019
- Kaplan et al., Scaling Laws for Neural Language Models, OpenAI 2020
- Hoffmann et al., Training Compute-Optimal Large Language Models, NeurIPS 2022
- OpenAI, Introducing ChatGPT, 30 novembre 2022
- OpenAI, Learning to Reason with LLMs, 12 septembre 2024
- DeepSeek, DeepSeek-R1, 20 janvier 2025
- METR, Measuring AI Ability to Complete Long Tasks, 2025
- Anthropic, Anthropic Economic Index, 2025, utilisation par pays et niveau de revenu
- Global Biodiversity Information Facility, données d’occurrence et biais géographique de leur échantillonnage, gbif.org et le blog des données GBIF
- Artificial Analysis, Intelligence Index by Open Weights and Proprietary, 26 août 2026
- Artificial Analysis, Intelligence Index vs. Cost per Intelligence Index Task, 26 août 2026
- NVIDIA, DGX Spark user guide and hardware overview
- The Computational Democracy Project, Polis, compdemocracy.org/polis et le code source
- The Computational Democracy Project, vTaiwan, étude de cas, depuis 2014
- AI Objectives Institute, Talk to the City, talktothe.city et ai.objectives.institute
- Team Mirai, kouchou-ai (広聴AI), écoute à grande échelle pour les municipalités japonaises, GitHub
- Team Mirai, AI interviews and the digital democracy manifesto, policy.team-mir.ai; Bruce Schneier et Nathan Sanders, Japan's Team Mirai Uses Tech to Bolster Democracy, Not Undermine It, Tech Policy Press, mars 2026
- Agora Citizen Network, agoracitizen.network et From ZK-first to AT Protocol, our path to DDS, blog
- Low, Duys, Formanek, Hammond, Bakker, Habermolt: Delegating Deliberation to AI Representatives, arXiv:2605.24413
- Tessler et al., AI can help humans find common ground in democratic deliberation (la machine Habermas), Science, 2024
- GainForest, Simocracy, un registre public d’agents IA créés par des citoyens sur AT Protocol, simocracy.org
- Foresight Institute et la Cooperative AI Foundation, Supercooperation: The Future of AI for Democracy, notes de l’atelier, atelier satellite de l’ICML, Séoul, juillet 2026
- Anthropic, What 81,000 people told us about AI, entretiens menés par l’IA à grande échelle
- Google, Measuring the environmental impact of delivering AI at Google scale, arXiv:2508.15734, août 2025
- Epoch AI, How much energy does ChatGPT use?, 2025
- GainForest,
footprint.tsdans pi-village-core, le calcul des chiffres de Polly par compte - GainForest, Generative AI + Climate Guide 2024, préparé pour le Climate Youth Negotiator Programme avant la COP29
Qui a fait ce guide
Ce guide vient de GainForest et de la Youth Negotiators Academy, écrit pour le Climate Youth Negotiator Programme.
Rien de ce que vous tapez ici ne quitte votre navigateur, et la recherche tourne en local.
Nous le mettons à jour à mesure que les outils changent. Si quelque chose est faux, périmé ou manquant, dites-le nous. Si vous voulez faire tourner votre propre IA souveraine, former votre délégation ou travailler avec nous sur la prochaine édition, écrivez à team@gainforest.net.
Avec le soutien de Robert Bosch Foundation et de Protocol Labs.
team@gainforest.net